大模型卷了两年脑子,Kakao 开始卷眼睛了
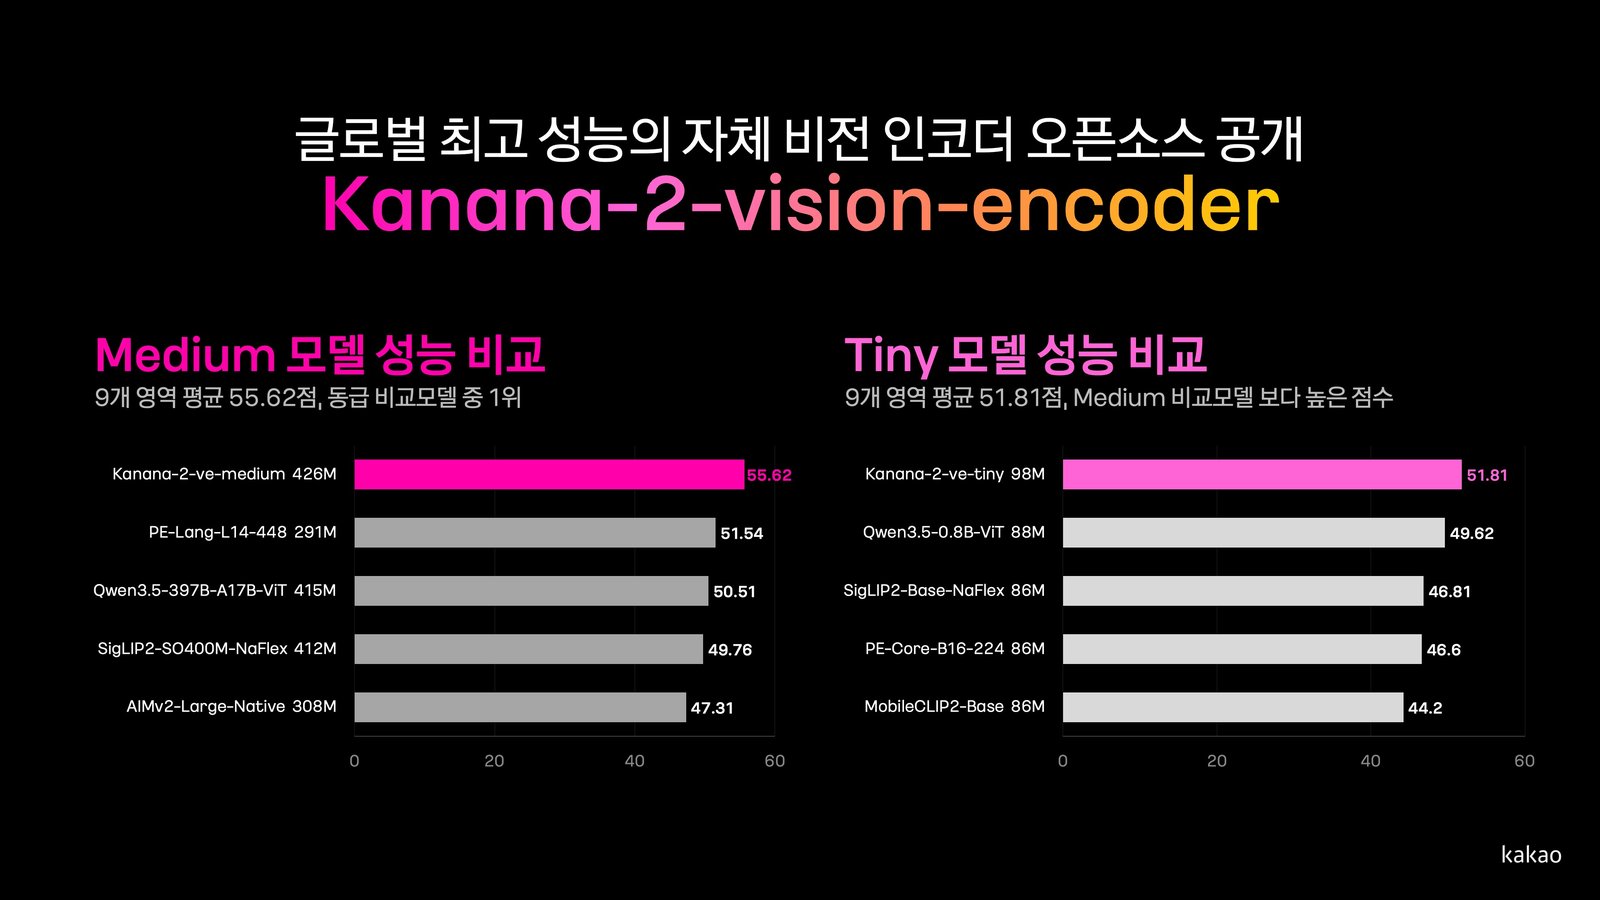
Kakao 在 Hugging Face 开源 Kanana-2 视觉编码器:medium 4.26 亿参数、tiny 9800 万参数,Kanana Open License 可商用;官方称 42 个基准超过 SigLIP 2 等对手。
大模型这两年,卷脑子卷疯了。
参数、推理、思考链,一个比一个响。
但很少有人问一句:
它的眼睛怎么样?
01
先说事。
10 月 21 日,韩国的 Kakao 在 Hugging Face 上开源了两个视觉编码器,叫 Kanana-2-vision-encoder。
一个 medium,4.26 亿参数。
一个 tiny,9800 万参数。
这事其实在 10 月 13 日的 if(kakao)26 上就预告过了。
这次是真放出来了。
视觉编码器是干嘛的?
说白了就是,多模态模型的眼睛。
图片进来,先由它看一遍,把看到的东西翻译成语言模型能懂的东西。
眼睛要是看不清,后面的脑子再聪明,也只能瞎猜。
02
成绩单是这么写的。
Kakao 官方称,他们在 9 个领域、42 个基准上做了评测。
里面有通用视觉问答,有英文 OCR 和文档理解,有韩文 OCR 和文档理解,有视觉定位和细粒度感知,等等。
对手也都不是小角色。
Google 的 SigLIP 2,Meta 的 Perception Encoder,Apple 的 AIMv2,阿里的 Qwen3.5-ViT。
官方称,Kanana 的两个模型都超过了它们。
尤其是 tiny。
在视觉定位、韩语考试、韩文 OCR 和文档这几项上,官方称领先得特别明显。
还有两个数字。
一个是,借助自家的 Kanana-2 语言模型,视觉编码器的训练效率提高了约 4 倍。
另一个是,针对高分辨率图像做了优化,延迟比主流视觉编码器低 60% 以上。
好看吗?
好看。
但冒昧了,得提醒一句——
以上全部是 Kakao 自己测、自己报的。
42 个基准是谁挑的,怎么跑的,对手用的什么配置,目前只有官方一家的说法。
没有第三方复测之前,这些成绩单,先当成广告词看。
03
有人可能会问。
市面上现成的视觉编码器那么多,Google 有,Meta 有,Apple 有,阿里也有。
Kakao 为什么非要自己造一个?
我的理解是,用别人的眼睛,就得按别人的方向看世界。
别人的模型,优先照顾的是别人的主力语言和主力场景。
韩文的小字、韩文的表格、韩国的考试题,未必在别人的优先级清单上。
而 Kakao 的用户,天天面对的就是这些。
——这还不算完。
眼睛是自己的,训练的时候就能跟自家的语言模型配合。
Kakao 说的训练效率提高约 4 倍,靠的就是自家的 Kanana-2 语言模型。
脑子和眼睛都是自己的,才能一起调。
说白了,这是一笔供应链的账。
关键零件握在自己手里,以后的路才好走。
(以上是我的解读,Kakao 官方的说法是自研、并会陆续开源其余组件。)
04
那这事到底值不值得关注?
我觉得值得,原因不在成绩,在账本。
你想想,一个多模态模型,每看一张图,都要先过一遍视觉编码器。
图越清楚,要处理的东西越多。
眼睛越大,每一次"看"花的算力就越多。
算力是要钱的。
所以,在同样看得清的前提下,眼睛越小越好,越快越好。
这就是 tiny 存在的意义。
Kakao 说,tiny 是用知识蒸馏和瘦身做出来的端侧版本。
端侧是什么意思?
就是不上云,直接在手机、电脑上跑。
不上云,就不用每一张图都付一次云上的账。
对做产品的人来说,这比什么榜单第一都实在。
还有一层。
高分辨率和低延迟,本来是一对冤家。
图看得越细,处理得越慢。
想快,就得把图压小,一压,小字就糊了。
Kakao 这次的说法是,两头都要:既针对高分辨率做了优化,又说延迟比主流视觉编码器低 60% 以上。
如果这个说法经得起复测,那它省下的就不只是算力,还有用户等待的那几下。
如果经不起,那也就是又一张漂亮的 PPT。
那 medium 和 tiny 怎么选?
官方没给选型建议。
按常理推,服务器上追求效果的,可以先试 medium,要塞进手机、对成本敏感的,先试 tiny。
这是我的推断,具体还得拿自己的业务图片跑一跑。
05
还有一个更大的背景。
Kakao 的负责人在发布时说了一段话,大意是:在 Agent 时代,Computer Use,也就是让 AI 直接看懂并操作电脑和手机屏幕,会让高分辨率的视觉编码器变得更加重要。
这话怎么理解?
你让 AI 帮你点按钮、填表格、找菜单。
它得先看清屏幕。
屏幕上的字很小,按钮挤在一起,弹窗一层盖一层。
眼睛差一点,就点错地方。
点错一次没什么。
点错的是付款按钮呢?
所以,Computer Use 这条路要走通,眼睛是绕不过去的一关。
假设一个场景(纯属假设):
你让手机上的助手帮你在某个 App 里改一下收货地址。
它得先认出哪个是输入框,哪个是保存按钮,哪个是一闪而过的广告。
这一连串动作里,每一步都靠眼睛。
脑子负责想"该点哪",眼睛负责回答"那个东西在哪"。
谁的眼睛又小、又快、又看得清,谁就更有机会把 Agent 塞进每一台手机里。
Kakao 手里握着韩国的国民级聊天软件 KakaoTalk。
它想干什么,不难猜。
当然,这是我的猜测,Kakao 并没有公布具体的产品计划。
06
最后说几句实在的。
第一,许可证。
这两个模型用的是 Kanana Open License,官方说允许商用。
想拿来用的,自己去 Hugging Face 把条款看一遍,别光看"允许商用"四个字。
第二,语言。
tiny 领先最明显的几项,有好几项是韩语相关的。
这对韩国本地的产品是好消息。
对中文场景好不好用?
官方没给中文的数据。
想用,得自己测。
第三,用途。
开发者能拿它干什么?
我能想到的,比如读截图、读扫描件、读表格,或者给自家的 Agent 配一双能看屏幕的眼睛。
这些是我的设想,不是 Kakao 公布的案例。
能不能用好,还得看你自己的数据。
第四,后续。
Kakao 说,全模态模型 Kanana-o 的其他组件,之后也会陆续开源。
注意,是"之后"。
今天能下载的,就是这两个视觉编码器。
其余的,等放出来再说。
写在最后
这两年,大家习惯了用参数量来衡量一个模型的本事。
越大越厉害,越大越贵。
Kakao 这次反着来,把一个 9800 万参数的小眼睛摆上台面,官方称它对上 400M 级的对手也不落下风。
是不是真的,交给时间和第三方去验证。
但这个方向,我是认的。
为什么认?
因为最后掏钱的,不是榜单,是每一次调用。
一个产品一天要看多少张图,眼睛就要睁多少次。
每睁一次眼都要钱的时候,小而准的眼睛,就是最直接的省钱办法。
大厂可以拿算力堆效果。
中小团队拼的,是同样的效果,谁花得更少。
从这个角度看,Kakao 把小眼睛开源出来,最该高兴的,其实是那些算力预算紧巴巴的人。
模型不一定要更大。
先把眼睛擦亮再说。
来源:Kakao 新闻稿(2026-10-21,韩文);Hugging Face 合集。42 个基准成绩、训练效率约 4 倍与延迟降低 60% 以上均为 Kakao 自测自报,未见第三方复测,官方未给中文场景数据;负责人发言为意译;自研动机、选型建议与产品意图为作者推断,改地址场景纯属假设。