一个库吃下所有量化格式:蚂蚁和 vLLM 开源推理内核库 Humming
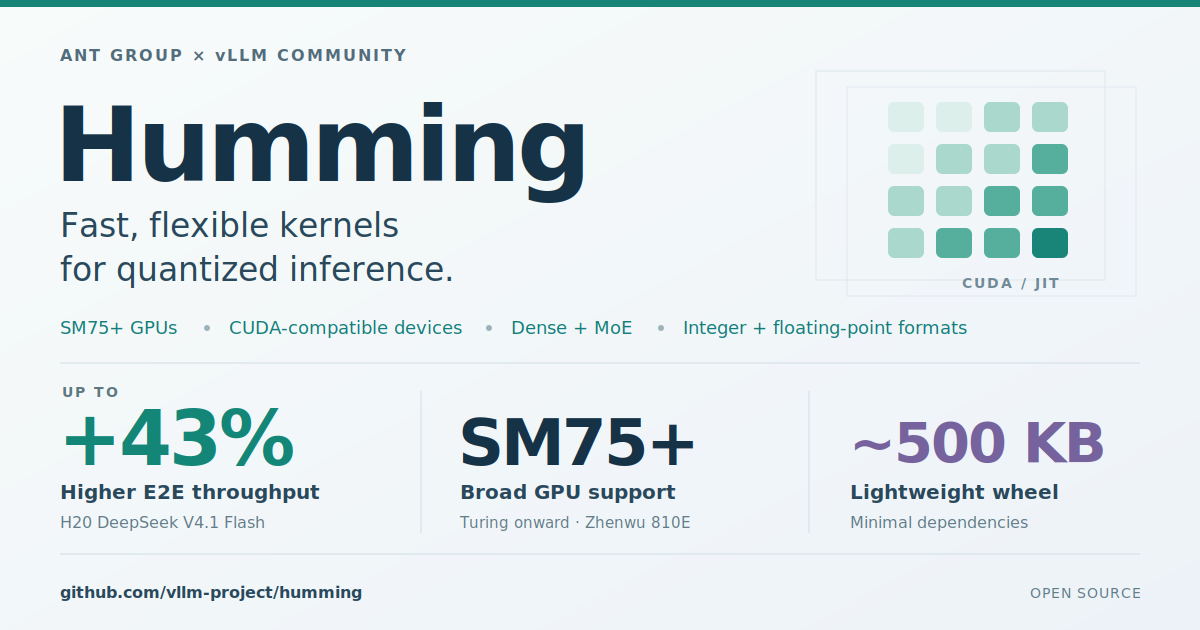
蚂蚁集团与 vLLM 社区开源量化推理内核库 Humming:统一的量化表示加即时编译,支持 Turing 起的 NVIDIA GPU 和平头哥真武 810E,vLLM 0.29.0 起 CUDA 版自带。
本周,蚂蚁集团和 vLLM 社区一起开源了一个项目,叫做 Humming。
它是一个量化推理的内核库。
这句话听上去很硬核,普通读者可能直接跳过了。
但是,我觉得它解决的问题,值得每一个自己部署大模型的人了解一下。
因为它针对的不是"模型够不够聪明",而是一个很少被提起的老麻烦:量化格式太多了,每一种格式都要单独写一套内核。
量化是怎么回事
先用大白话说一下量化。
大模型的参数,本来是用比较高的精度存储的。
量化就是把这些数字"压一压",用更少的位数来存,从而少占显存、少搬数据。
所以,大家在模型名字后面,常常看到 W4A16、W4A8、W8A8 这样的后缀。
按照行业惯例,W 指权重(weight),A 指激活值(activation),后面的数字是位数。
W4A16 的意思,大致就是权重用 4 位存,计算时的激活值用 16 位。
(这一层解释是通用惯例,具体格式细节以各量化工具的文档为准。)
问题在于,压缩的办法不止一种。
同样是 4 位,可以是整数,也可以是浮点;缩放因子可以按组算,也可以按块算;不同的量化工具,导出的文件布局也不一样。
每种格式一个内核
格式多了,麻烦就来了。
GPU 要真正跑出量化的好处,需要专门的计算内核(kernel),也就是直接在显卡上执行矩阵乘法的那段底层代码。
据 vLLM 官方博客的说法,过去的常见做法是"每种组合写一个专用内核"。
每加一种组合,就要配套写权重预处理、内核选择、框架适配和测试。
某个优化做好了,还得挨个搬到其他实现里去。
打个比方,这就像家里每买一个电器,都要配一个专用充电器,抽屉里塞满了各种插头,坏了一个还不知道换哪个。
(这个比方是我自己打的,不是官方说法。)
对于维护者来说,这是一种越来越重的负担。
对于普通用户来说,结果就是:你想用的那个量化格式,未必有人给你的显卡写好了快的内核。
Humming 的做法
Humming 的思路,用一句话概括就是:先统一描述,再按需拼装。
官方博客介绍了几个关键设计。
1、统一的表示。
各种量化工具导出的格式,先被转换成"Humming 标准格式"。
不管原来是哪家的文件,进来以后都用同一套方式描述权重、缩放因子、零点等信息。
2、三层配置。
内核由三个配置来描述:Layer Config、Compute Config 和 Tuning Config。
照我的理解,Layer Config 描述"这一层长什么样",Compute Config 描述"要做哪种计算",Tuning Config 描述"在这块显卡上怎么跑最快"。
(以上三句是我的通俗理解,准确定义以官方文档为准。)
3、即时编译和缓存。
Humming 不预先打包一大堆编译好的内核,而是用 NVRTC 或 NVCC 即时编译(JIT),编译结果缓存起来复用。
4、不依赖重型框架。
官方称,它的 CUDA 实现比较轻量,没有依赖重型的内核框架,所以即时编译本身也很快。
这就好比,从"每个电器配一个充电器",变成了"一个万能底座,加一组可以自由组合的转接头"。
编译有多快
即时编译有一个担心:现场编译会不会很慢?
官方博客给了一组测试数据(下面的数字均为官方自报)。
在 H200 + CUDA 13.4 的环境下,编译单个 W4A16 内核,CUTLASS + NVCC 需要 23.35 秒。
Humming 用 NVCC 是 1.82 秒,用 NVRTC 是 1.88 秒。
另外,为单个层编译并加载覆盖所有 M 尺寸的内核,官方称大约需要 2–4 秒。
这意味着,"为新场景现场准备内核"这件事,变得可以接受了。
跑得有多快
再看性能。
下面这些都是 vLLM 社区跑的内核微基准,属于官方自报,我没有找到第三方复测。
1、W4A16 小 batch,在几款设备上相对 cuBLAS 约 3–4×。
2、H200 上的大 batch,约为 Marlin 的 2×;部分 B300 场景在 3× 以上。
3、B300 上的 Grouped MoE 路径,约 5×。
4、Hopper 架构上,中小 batch 时,W4A8-MXFP4 相对 DeepGEMM 的 W8A8,H20 上约 4.2×,H200 上约 4.5×。
微基准只测单个计算内核,跟整个服务跑起来是两回事。
所以,官方还给了一个端到端的测试。
模型是 DeepSeek-V4.1-Flash,硬件是 8×H20,TP=8。
把 MoE 部分从 Marlin 的 W4A16 换成 Humming 的 W4A8,官方称吞吐提升 14%–43%,首 token 延迟(TTFT)降低约 25%–32%。
并发 64 时,输出速度从 442.37 tokens/s 提高到 633.94 tokens/s。
这些数字很好看,但我建议大家把它们当作"值得自己测一测"的理由,而不是直接写进采购报告的结论。
一个有趣的细节
博客里有一个细节,我觉得很好玩。
社区发现,Blackwell 架构的 Tensor Core 其实"隐藏"支持两种特殊的浮点格式----float4e0m3 和 float8e3m4。
这两种格式并没有在 PTX 里暴露出来,但硬件能算。
Humming 已经支持了它们。
不过官方也说明,Rubin 不支持这两种隐藏格式。
这件事说明,硬件的能力,并不总是写在说明书上的,要靠社区一点点挖出来。
支持哪些硬件
据官方介绍,Humming 支持 NVIDIA 从 Turing 开始的所有架构,也就是 SM75 及以上。
另外,它还支持平头哥真武 810E 等兼容 CUDA 的设备。
一个内核库同时照顾到老显卡和国产芯片,我觉得这一点很有意义。
怎么使用
安装很简单。
pip install humming-kernels
官方称,wheel 包只有约 500KB,因为内核是按需编译的,不需要打包大量预编译文件。
如果你用 vLLM,从 vLLM 0.29.0 开始,CUDA 版本已经自带 Humming,不需要单独安装。
启动服务时,可以用下面两个参数,把普通矩阵乘法和 MoE 的计算后端都切到 Humming。
--linear-backend humming --moe-backend humming
还有一个 --quantization humming 参数,用来兼容 GPTQ INT3 等 vLLM 本身没有原生支持的格式。
接下来
官方路线图提到了几件事:autotune(自动调优)、支持更多平头哥 PPU 设备(比如真武 M890),以及量化的 A2A 通信。
需要注意,这些都是计划,还没有发布。
我的看法
我觉得,Humming 最值得关注的地方,不是某一个倍数,而是它的思路。
把"每种格式一套代码"变成"一套代码组合出所有格式",这是一种对抗软件熵增的办法。
代码如果没有人整理,一定会越来越乱,专用内核越写越多,维护成本也越来越高。
Humming 做的事情,就是重新建立秩序。
而且它是开源的。
这意味着,不管你用的是老一点的显卡,还是兼容 CUDA 的国产芯片,都有机会用上同一套优化,而不用等某家厂商专门为你写一个内核。
对自己部署模型的个人和小团队来说,这是实实在在的好处。
如果你正在自己的机器上跑量化模型,又苦于找不到合适的快速内核,可以试试它。
(完)
来源:vLLM 官方博客(2026-10-21);Humming GitHub 仓库。编译时间、内核微基准与 DeepSeek-V4.1-Flash 端到端数字均为 vLLM 社区自报,未见第三方复测;autotune、真武 M890 等 PPU、量化 A2A 通信为路线图计划,尚未发布;W/A 命名解释、三层配置的通俗说法与充电器比方为作者理解。