世界不会等你想清楚:米哈游 GameScaling 的三个变量
米哈游联合清华等高校开源 GameScaling:基于 Qwen3.5 的 0.8B 到 27B 游戏 Agent 模型,用 120 组实验拟合数据量、多样性和模型规模三者的缩放规律。
01 想得深,还是出手快?
打游戏,是想得深重要,还是出手快重要?
想一想再回答。
很多人会说:当然是想得深。看清局势,想好对策,才能赢。
这话在下棋时是对的。棋盘不会动,你想多久,对手就等多久。
但大多数游戏不是下棋。
怪物不会等你,掉下去的方块不会等你,对面的玩家更不会等你。
为什么?因为世界不暂停。
世界不暂停 → 每一步都要快 → 想得再深,来不及出手也是零。
10 月 22 日,米哈游的崩坏 AI 团队,联合清华、国科大、港大、北大(另有新加坡国立大学参与),开源了一个叫 GameScaling 的项目。
它研究的,正是这个问题。
02 它做了什么
先把事实摆清楚。
GameScaling 基于 Qwen3.5 训练,有 0.8B、2B、9B、27B 四个尺寸。
数据配方有两种:S1 只用《我的世界》(Minecraft)数据;S3 混合多款游戏,其中 Minecraft 占 27%。
两种配方、四个尺寸,官方一共开源了 8 个权重。
模型做的事情很简单:看画面,输出接下来 200 毫秒的键盘和鼠标操作。需要的时候,也可以先推理再出手。
也就是说,它像人一样,看屏幕、按键盘、动鼠标。
200 毫秒,是什么概念?
就是一眨眼的工夫。
模型每看一眼画面,就要决定接下来这一眨眼里,手该怎么动。
它可以选择先推理再出手,也可以直接出手。
这就带来一个经营者很熟悉的问题:什么时候该停下来想,什么时候该直接干?
想多了,错过时机。想少了,动作变形。
这不是游戏才有的问题,是所有在实时环境里做决策的人,每天都在面对的问题。
03 一条三个变量的规律
这个项目最有价值的,不是某个分数,而是一条规律。
据作者团队介绍,他们一共跑了 120 组配置:
数据量从 50 小时到 1,600 小时,分六档;
数据多样性从 S1 到 S5,分五种配比;
覆盖 80 款游戏,总计算量 2.2×10²² FLOPs。
最后得出一条三因素的 scaling law,我用一个式子来概括(这是我的写法,不是论文原文):
能力 = 数据量 × 多样性 × 模型规模
三个变量,缺一个都不行。但更重要的是,它们各自管的范围不一样。
据作者团队的发现:
数据量,主要帮助训练集里已有的游戏;
多样性,帮助迁移到相似的世界,但对差异很大的世界帮助有限;
模型规模,要和多样性一起看。只用单一世界训练时,大模型学得更快,但泛化反而更差。
这一条,值得多读两遍。
大模型,不是越大越好。
而是:没有多样性的大,只是更快地学会了一个世界的偏见。
把这条规律翻译成商业语言,你会发现它一点也不陌生。
一家公司只在一个市场里打拼,规模越大,在这个市场里越熟练,学得越快。
但换一个市场,它过去越成功,往往越难转身。
为什么?因为它学到的,有一部分是这个市场特有的东西,而它自己分不清哪些是规律、哪些只是习惯。
多样性的作用,就是帮你把“规律”和“习惯”分开。
见过的世界越多,越知道什么是到处都成立的,什么只是这里成立的。
但也要注意作者团队的另一半结论:多样性对差异很大的世界帮助有限。
见过很多相似的世界,不等于能应付一个完全陌生的世界。
这一点,同样适用于人,也适用于公司。
04 先学会“手”,再学会“脑”
还有一个发现,很有意思。
据作者团队观察,训练的早期,模型先学会的是键盘鼠标这套操作界面本身,这时候的进步是全面的,几乎所有游戏都跟着变好。
到了后期,进步就变窄了,只在特定的游戏上提升。
这像不像一个新人进公司?
刚开始,先学会用电脑、用系统、走流程,每件事都顺手了一点。
再往后,才是在某个具体岗位上越做越深。
接口能力是地基。专业能力是楼层。
地基没打好,楼层盖不上去。
(这个类比是我的理解,不是论文的表述。)
05 快,才有机会
回到开头那个问题。
作者团队自报了几组数据,我原样列出:
在 MCU 基准上,27B-S1 的成绩是 63.3%,对比的 GameWAM 是 50.7%。
在实时模式下,9B-S3 得分 25.3,对比的 Gemini 3.8 Flash 是 19.2。
速度上,前沿大模型每一步要 4–24 秒,GameScaling 是 0.13–0.69 秒。
以上全部是作者团队自报,比较条件以论文为准。
我想强调的是“实时模式”这几个字。
这个对比,只说明在世界不暂停的条件下,一个专门训练、出手快的模型,可以拿到更高的分。
它不说明 GameScaling 在所有条件下都比大模型强。
这两件事,要分开看。
06 多给几步,会怎样?
还有一组数据,我觉得比上面的更值得玩味。
据作者团队,把每局允许的步数上限从 600 提高到 3,000:
9B-S1 的成功率从 50.9% 提高到 69.3%;
0.8B 从 42.3% 提高到 59.3%;
而没有经过训练的基座模型,几乎没有变化。
这说明什么?
不是给的时间越多越好,而是:
先要有本事,时间才有用。
本事 × 时间 = 结果
本事是零,给再多时间,结果也是零。
这和很多人对“时间”的理解,正好相反。
我们常说:再给我一点时间,我一定能做好。
可如果底子不在,多出来的时间,只是让你在原地多转几圈。
反过来,有了底子,时间就成了放大器。
所以,与其问“我需要多少时间”,不如先问“我有没有让时间起作用的本事”。
对模型是这样,对团队也是这样。
07 对谁有用?
那这件事,和不做游戏的人有关系吗?
有关系。
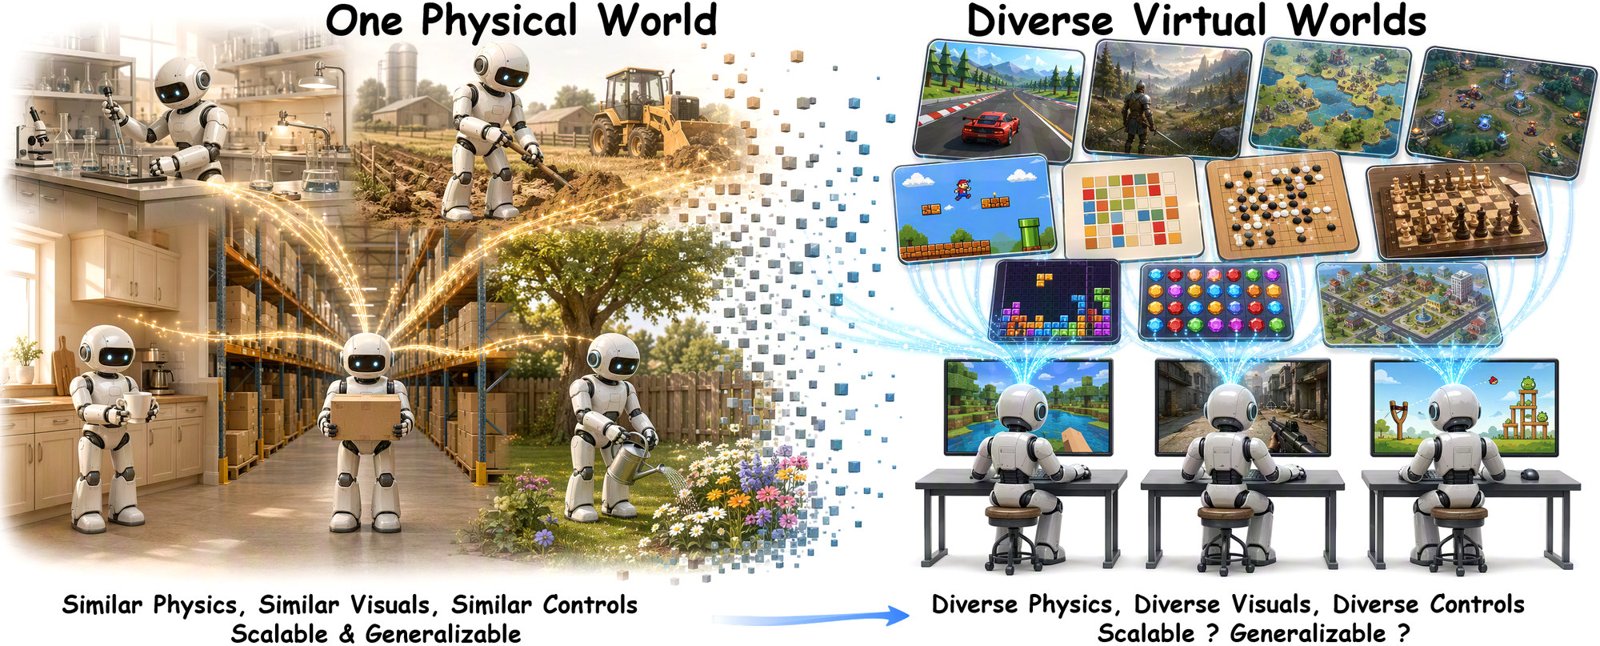
“看屏幕,动键鼠”这个能力,和游戏里的 NPC、现实中的机器人、电脑上的 Computer Use,是同一类问题。
它们都面对一个不暂停的世界。
都需要在想清楚和来得及之间,找到平衡。
游戏是一个很好的练兵场。
它便宜,可以反复试错,规则清楚,结果可以量化。
在游戏里摸清楚的规律,未必能原样搬到现实里。
但至少,它让我们第一次能比较系统地回答一个问题:数据量、多样性、模型规模,三样东西各该投多少?
对任何要做“看屏幕、动手”这类 Agent 的团队来说,这是一个比单个分数更有用的问题。
GameScaling 的权重和推理代码以 Apache 2.0 开源。想自己跑一下的,官方给的启动命令是:
bash scripts/serve_vllm.sh THUSI-Lab/GameScaling-9B-S1 8000
最后的话
想得深,是一种能力。
出手快,也是一种能力。
但真正决定结果的,是你在哪种世界里比赛。
在会暂停的世界里,比的是谁想得更深。
在不暂停的世界里,比的是谁能在来得及的时候,做出足够好的判断。
世界从来不等人。
能赢的,是那些不等世界停下来的人。
来源:GameScaling 项目页;GitHub 仓库;Hugging Face 模型合集;arXiv 论文。所有成绩为论文作者自测;与 Gemini 3.8 Flash 的对比只限论文的“实时”模式,在游戏暂停等待的模式下前沿模型分数更高;GameScaling 在自有 H200 集群上部署,前沿模型经公开 API 调用、含网络延迟,延迟对比口径不同;GameWAM 基线分数引自原论文;训练数据与训练代码未公开,权重仅供研究使用,游戏版权归各发行商;配图中的游戏画面为项目方示意图。