发动机能换,车还得自己修:IQuest-Q1 想当你编程 Agent 的底座
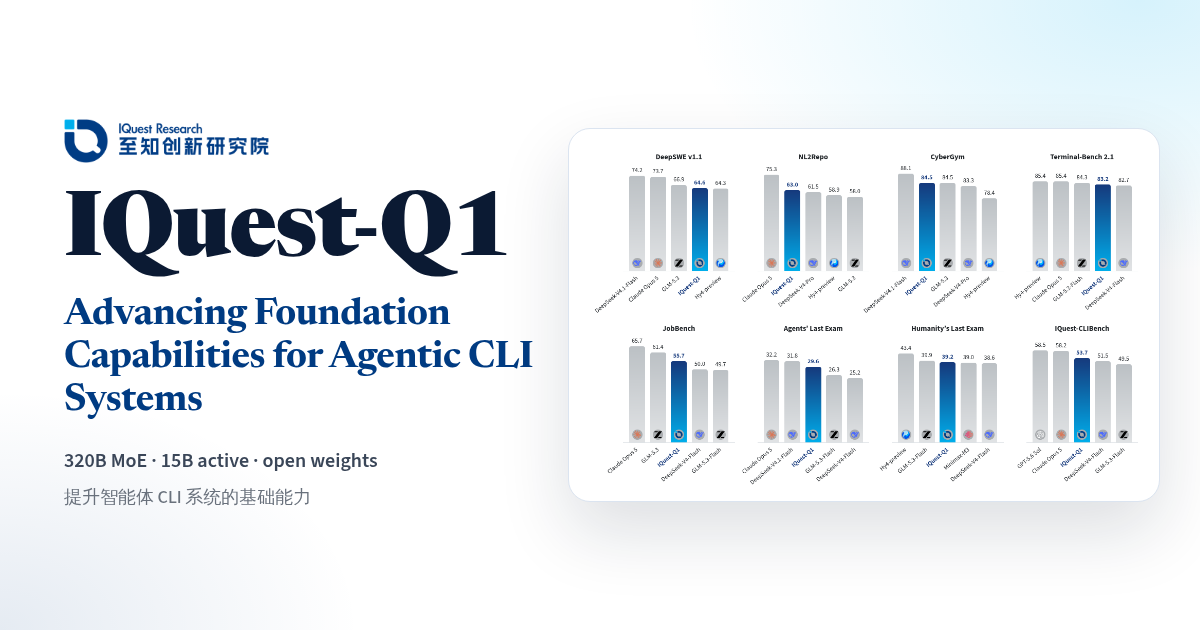
IQuestLab 开源 IQuest-Q1:约 320B 总参数、15B 激活的 MoE 模型,模型卡直接给出接入 Claude Code 和 Codex CLI 的配置,想当命令行编程 Agent 的可自托管底座。
01 发动机,和装得进去的发动机
一辆车,最值钱的部件是什么?
很多人会说:发动机。
但真正决定你能不能开上路的,往往不是发动机有多强,而是它能不能装进你现在这辆车。
编程 Agent,也是这个道理。
这两年,Claude Code、Codex CLI 这类命令行编程 Agent,成了很多开发者每天都要打开的工具。
工具是好工具。
可底座,是别人的模型。
代码能不能出门,账单涨不涨,规则改不改,都不由你说了算。
那么,底座能不能换?
最近,IQuestLab 放出了开权重模型 IQuest-Q1,同时在 Hugging Face Papers 上挂出了论文 “Advancing Foundation Capabilities for Agentic CLI Systems”。
这件事最值得看的,不是它有多大。
而是它的模型卡里,明明白白写着:怎么把它接进 Claude Code,怎么把它接进 Codex CLI。
不是造一台“通用发动机”,而是按别人家的车型尺寸,造一台发动机。
02 它是一台什么样的发动机
先看事实。据模型卡和论文,IQuest-Q1 是一个稀疏 MoE 模型。
总参数约 320B,激活约 15B。
88 层,256 个专家,每次路由 8 个。
隐藏维度 3072,Q/KV 头 48/8。
注意力是混合的:3 层滑动窗口(窗口 4096),配 1 层全注意力。
上下文 512K,纯文本,不看图。
这一串参数,翻译成经营语言,就是一句话:
不是养一支全员上岗的大军,而是养一个很大的专家库,每次只派一小队出门。
大库存 × 小派单 = 能力和成本之间的折中
这是今天大模型的主流打法,IQuest-Q1 并不例外。
再看上下文。512K,纯文本。
对一个命令行 Agent 来说,这意味着什么?
我的理解是:它要读的东西,本来就几乎全是文字。代码、日志、报错、终端输出,没有一张图。
不看图,不是短板,而是取舍。把力气花在 Agent 每天真正要读的东西上。
真正让它不一样的,是训练。
03 为谁训练,比训练多少更重要
据论文,训练分三个阶段。
预训练:Stable SplitNorm + Muon + muP,第二阶段加大代码数据的比例。
Mid-training:扩展领域和格式,逐步拉长上下文。
后训练:在多种脚手架、多个版本上做 SFT、领域 RL 和 MOPD,最后做模型合并。
我想请你多看一眼这几个字:多脚手架,多版本。
为什么?
因为 Agent 的真实工作环境,从来不是一个。
今天用 Claude Code,明天换 Codex CLI,后天工具又升了一个版本。
只在一种脚手架里训出来的模型,换个壳子,就容易水土不服。
在很多脚手架里训出来的模型,才有可能成为一个“通用接口”。
还有一个细节。论文称,训练用了超过 100 万个容器化任务实例,并用环境完整性检查和轨迹审计,来控制 reward hacking。
Reward hacking 是什么?
简单说,就是模型学会了钻考试的空子,而不是学会了干活。
真实任务 × 防钻空子 = 真本事
后一项缺了,前一项越多,学到的空子也越多。
04 成绩单,要怎么读
下面的成绩,全部是 IQuest 方面自报,据 AI Weekly 转述论文:
SWE-Bench Pro:57.5。
DeepSWE v1.1:64.6。
GPQA Diamond:93.3。
BrowseComp:85.5。
自报成绩,不等于假成绩。
但它是“考生自己公布的分数”。考试给了多长时间,用的什么规则,都得回到论文里一条条看。
论文里还有一组更特别的说法。
论文称,在一次三天的部署里,人类安全专家在 IQuest-Q1 的辅助下,产出了 30 份漏洞报告,经其他专家独立验证,并已负责任披露。
论文没有列出 CVE 编号,也没有列出项目名。
所以这件事,我们目前只能读作“作者的说法”,没法逐条对照。
那么,自报成绩到底该怎么用?
我的建议是,把它当成“入围通知”,而不是“录用通知”。
入围,说明值得你花时间去测。
录用,得看它在你自己的代码库、你自己的任务里,表现怎么样。
别人的考场,替不了你的工地。
05 换底座,真正的成本在哪里
这是本文最想讲的部分。
能接进 Claude Code,不等于你明天就能换。
为什么?
因为模型只是发动机。换发动机,要动的是整辆车。
我把它拆成一个式子(这是我的概括,不是官方说法):
自托管成本 = 算力 + 网关 + 安全配置 + 合规
第一,算力。
模型卡给的部署方式,是 8 卡张量并行,跑在 SGLang 或 vLLM 上,启动时带上 --tool-call-parser iquest_q1 --reasoning-parser iquest_q1。
这不是个人桌面上的玩具,而是团队级的投入。
第二,网关。
Claude Code 说的是 Anthropic Messages 协议,Codex CLI 说的是 OpenAI Responses 协议。
你需要一个网关,把两种“方言”都翻译给同一个模型。
模型卡还给了推荐版本:Claude Code 2.1.140,Codex CLI 0.142.0。
推荐版本意味着什么?意味着工具一升级,你可能就要重新验证一遍。
第三,安全配置。这一条,我建议每个想尝鲜的人都停下来看一眼。
官方的 Codex 示例配置里,写着 approval_policy = "never" 和 sandbox_mode = "danger-full-access"。
照抄,就等于把审批和沙箱一起关掉。
示例是为了“跑起来”,不是为了“跑得稳”。这是两件事。
第四,合规。
许可证是修改版 MIT,商用产品要显著标注 “IQuest-Q1”。
To B 的团队,这一条最好提前和法务对齐。
这四项加在一起,你会发现一件事:
开源模型省掉的,是“许可费”这一项。
但它把另外几项,从供应商的账本上,挪到了你自己的账本上。
不是变便宜了,而是换了一种付钱的方式。
06 谁该换,谁不该换
假设一个场景(纯属假设,不是真实案例):一家软件公司,代码不允许离开内网,又想让工程师用上命令行编程 Agent。
对它来说,闭源底座的问题,不是不好用,而是不能用。
这时候,IQuest-Q1 提供的不是“更强的选项”,而是“可以拥有的选项”。
反过来,如果你是个人开发者,代码没有出网的顾虑,那么为了换底座去扛 8 卡的门槛,未必划算。
所以,问题从来不是“开源模型够不够强”。
而是:你要的是更强,还是可控?
如果答案是可控,可以用下面这张小清单自查:
- 算一算:团队有没有 8 卡推理的预算和运维能力。
- 搭一搭:网关能不能同时说两种协议。
- 改一改:示例里的审批和沙箱设置,先改回来再用。
- 问一问:商用标注要求,产品界面上放在哪里。
- 测一测:自报成绩,拿自己的真实任务再跑一遍。
结语
发动机能拆下来换,是开源世界往前走的一步。
但车能不能开上路,取决于你愿不愿意自己当修车师傅。
能换,是选择权。
会换,才是能力。
来源:Hugging Face 模型卡;Hugging Face Papers 论文页;AI Weekly;IQuestLab 项目页。参数、部署方式、推荐的 Claude Code 2.1.140 / Codex CLI 0.142.0 版本均据模型卡;SWE-Bench Pro 等四项成绩为 IQuest 自报、据 AI Weekly 转述论文,未见第三方复测;配图中的 Terminal-Bench 2.1 成绩是在每任务 8 小时预算下测得,比多数实际使用宽松,正文未采用;30 份漏洞报告为论文说法,未列 CVE 与项目名;官方 Codex 示例关闭了审批和沙箱,请勿照抄;许可证为修改版 MIT,商用需在界面显著标注 “IQuest-Q1”;“自托管成本”公式为作者概括。