你点的每一次"允许",都不是监督(Claude 把 Auto mode 设成默认之后)
Anthropic 宣布把 Auto mode 设为多数 Claude 应用新会话的默认模式,并公开了“用户约 97% 的权限弹窗都点了批准”等数据。
你以为你在把关。
每次 AI 要执行一个命令,弹窗跳出来,你看一眼,点"允许"。
再跳一次,再点一次。
这个动作给人一种很踏实的感觉:机器在干活,人在看着。
问题是,你真的在看吗?
据 Anthropic 官方称,在 Claude Code 里,用户对权限弹窗的批准率大约是 97%。
几乎每一次,都是"允许"。
这不是监督。
这是肌肉记忆。
弹窗消耗的是什么
先把一件事说清楚。
人的注意力不是无限的。
它更像一块电池。你每做一次判断,就耗掉一点。判断越琐碎,耗得越快,回报越低。
心理学里有个说法叫 psychic entropy,精神熵。注意力没有被引导到值得的地方时,就会自然地散开,变成噪声。
一个接一个的权限弹窗,就是在制造这种噪声。
它不要求你思考。
它只要求你反应。
而反应做久了,就会变成不反应。
举一个假设的场景,不是真实案例。
你让 AI 帮你整理一个项目。它先要读文件,你点允许。它要建一个目录,你点允许。它要装一个依赖,你点允许。
到了第若干次,它要删掉一个文件夹。
弹窗长得和前面每一次都一样。
你的手指比你的脑子先到。
这不是你不负责。
是这个流程,本来就没有给你留出判断的空间。
Anthropic 在官方文章里给了一组数字,正好描述了这个过程。下面这些都是 Anthropic 自报的,而且全部来自 Claude Code 的测试,不是应用端:
- 在会话早期,人工大约能拦下 17% 的危险命令
- 到了 50 次以上的提示之后,这个比例掉到大约 5%
- 同样的会话里,auto mode 的拦截率几乎不掉
人在变累。
分类器不会。
一个更不舒服的对比
如果只是"人会累",你可能觉得还好。多休息就是了。
但还有另一组对比,同样是 Anthropic 自报的 Claude Code 测试数据:
- 测试者是 1053 名付费用户
- 面对危险命令,人工只拦下了 13.6%
- auto mode 拦下了 89%
- 头对头比较:auto 拦下了 800 条人工放过的命令,人工只拦下了 6 条 auto 放过的命令
还有一组来自真实会话的分析(仍是 Anthropic 自报):在被安全流程标记复查的会话里,按严重程度 7 分及以上、且不是用户明确要求的伤害来算,手动批准的会话有 6.3% 出现了这类动作,auto 会话是 2.4%。
读这些数字的时候,要记住两件事。
第一,它们都是厂商自己测的。
第二,它们说的是 Claude Code。应用端会不会一样,官方没有给出同等的验证。
但即便打上这两层折扣,结论的方向也很难忽视:
让一个疲惫的人逐条点"允许",并不比一套专门训练过的过滤器更安全。
Anthropic 这次改了什么
说到正事。
10 月 22 日,Anthropic 更新了一篇官方文章,宣布把 auto mode 从 Claude Code 扩展到 Claude 的应用端。
具体安排是这样的:
- 从"下周"起,多数 Claude 应用上 Pro、Max、Team 的新会话,默认开启 auto mode
- 安全的动作直接放行,有风险的动作被拦下,然后另找路径
- 你随时可以切回 Manual
- Enterprise 组织在默认切换之前,会先收到给管理员的邮件
- 免费计划没有列在这次的名单里
注意时间。官方只写了"下周",没有给出具体日期。截至本文发布(10 月 25 日),Anthropic 官方还没有宣布应用端已经切换。
Claude Code 那边是先走一步的:
- 自 8 月 14 日起,Pro、Max、Team 的新会话已经默认 auto
- 分类器产生的额外 token,对这三档不再收费
- Enterprise、API、Bedrock 等目前还是 opt-in,官方计划在大约一个月内也改成默认
自动,不等于放手
很多人听到"默认自动",第一反应是:那我不就失控了?
不完全是。
据官方介绍,auto mode 有几条兜底规则:
- 连续 3 次被拦截,或者一个会话里累计 20 次被拦截,就回退到手动批准
- 有些动作是硬拒绝,比如外泄类操作
- 涉及 git 时,它会看目标仓库是公开还是私有
- 执行破坏性的 git 操作之前,会先看一眼 status
切换方式也不难。CLI 里按 Shift+Tab,桌面端用下拉菜单。管理员可以通过 defaultMode 和 disableAutoMode 来设定或关闭。
官方还提到了两项外部测试,也一并放在这里:
- Apollo Research 帮忙加固之后,把共享攻击集和 held-out 攻击集合起来看,漏拦率从 12% 降到 7%。注意,这是针对对抗性合成攻击的测试,不是真实流量里的漏拦率
- Trajectory Labs 跑了 72 个场景、每个 10 次,Claude 加 auto 的攻击成功次数是 0,GPT-5.6 Sol 加 Codex Auto-review 是 5.83%。评测条件写在原文脚注里,引用前最好去看一眼
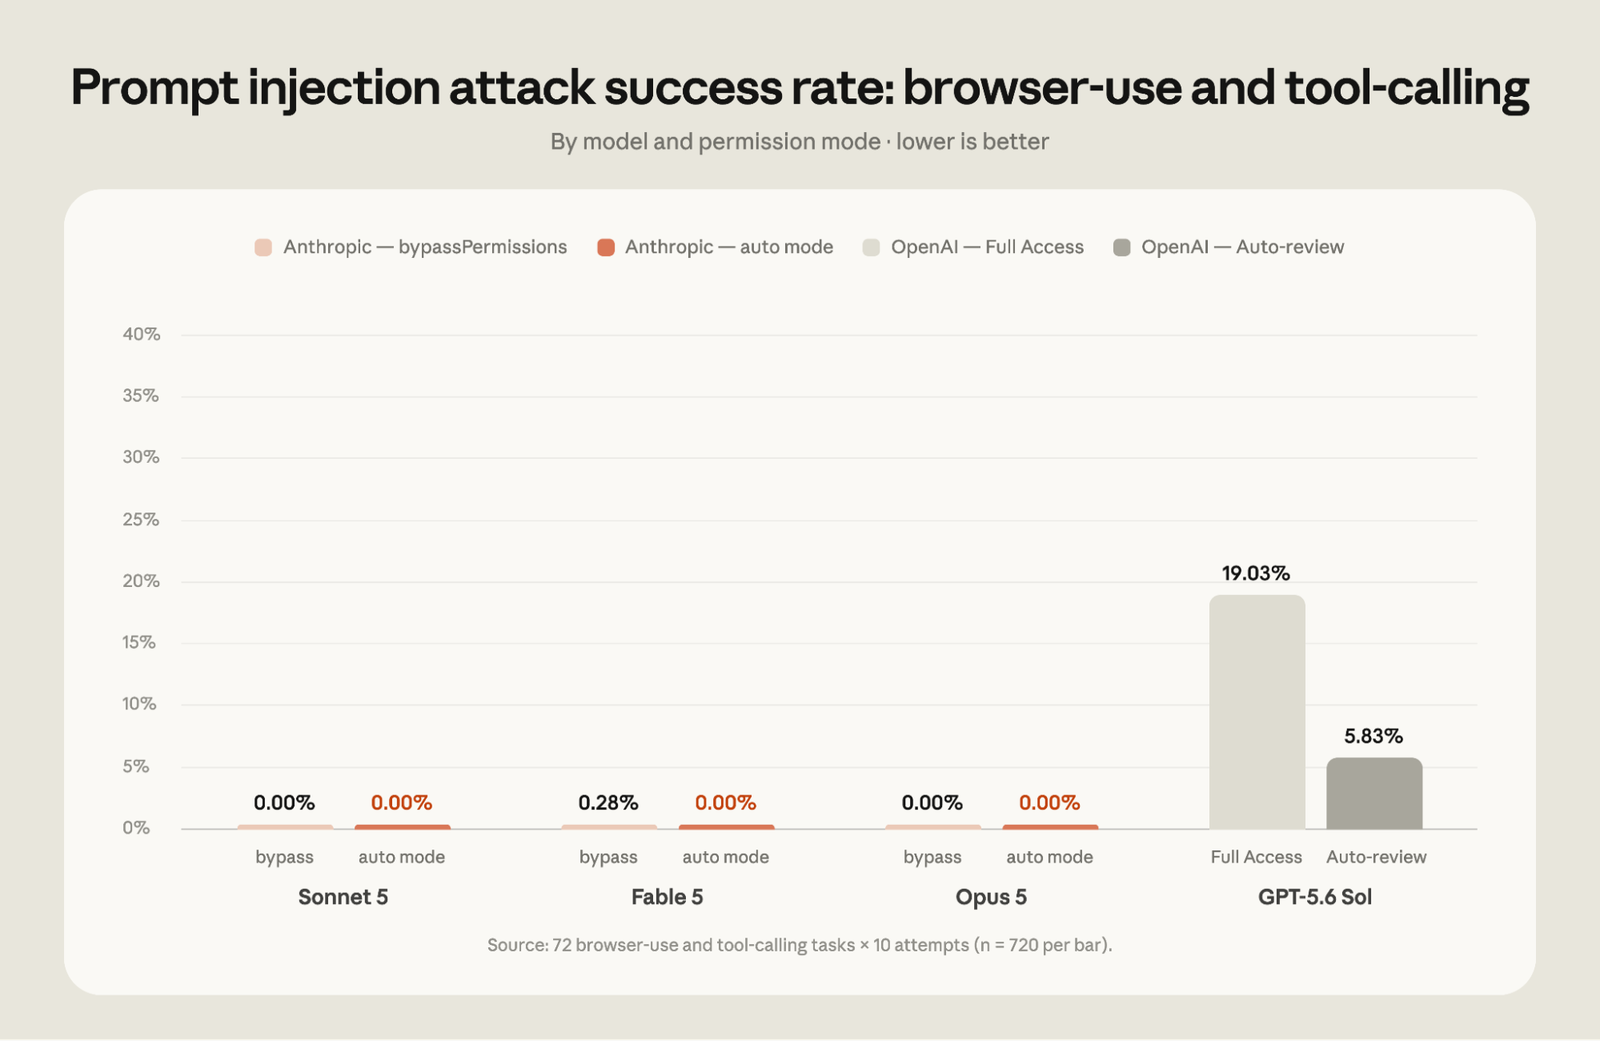
所以,更准确的说法是:
自动接管的是"逐条审批",不是"判断"。
真正值得你花注意力的地方
这里有一个容易被忽略的数字。
同样据 Anthropic 自报:用户对权限弹窗的批准率约 97%,但对 plan(计划)的拒绝率约 39%。
想一想这意味着什么。
逐条命令摆在面前时,人几乎不说"不"。
整份计划摆在面前时,人会认真地说"不"。
换句话说,人不擅长当检票员。
人擅长当导演。
你不需要盯着每一行命令。你需要的是看清楚:这件事要往哪个方向走,走到哪一步该停,哪些东西碰都不能碰。
这才是 taste,判断力,在 AI 时代真正的用处。
如果你打算让 auto mode 替你挡掉那些琐碎的弹窗,可以把省下来的注意力换到这几件事上:
- 在开始之前,把目标和边界写清楚,而不是在过程中逐条纠正
- 认真读 plan,该拒绝就拒绝,这是你最有效的那一下
- 把绝对不能碰的东西(生产库、私密仓库、外部账号)明确告诉它,并在需要时切回 Manual
- 定期看一眼它被拦下了什么,这比看它放行了什么更有信息量
默认值才是真正的开关
还有一点,常常被低估。
设置页里的开关,大多数人一辈子都不会去碰。
人用的,是默认值。
所以这次改动真正的分量,不在于"多了一个 auto mode"。这个模式在 Claude Code 里早就有了。
分量在于,它变成了新会话的起点。
以前,你要主动选择让 AI 自己跑。
以后,你要主动选择让自己回来逐条点。
选择的方向反过来了。
这对两类人意味着不同的事。
如果你本来就习惯一路点允许,默认 auto 大概率会让你更安全,因为你那一下点击本来也没在把关。
如果你确实在逐条细看,比如在动生产环境,那就记得,切回 Manual 这件事,现在要你自己去做了。
最后
点"允许"让人有掌控感。
但掌控感和掌控,是两回事。
真正的掌控,不在于你按了多少次按钮。
在于你把注意力,花在了值得判断的那一刻。
来源:Anthropic 官方文章(10 月 22 日更新);AI Crew School。官方 10 月 22 日的更新只说应用端“下周”起陆续默认开启,适用 Pro、Max、Team 套餐,截至发稿(2026-10-25)未见官方宣布已上线;97% 批准率、13.6% 与 89%、漏拦率、6.3% 与 2.4% 等数据均为 Anthropic 自报;Trajectory Labs 的对比由 Anthropic 引用,评测条件见原文脚注;文中观点为作者看法。