讲到天亮,明晚接着讲:腾讯混元 Hy-Nomas 想让视频「续写同一个世界」
腾讯混元开源交互式世界模型 Hy-Nomas:按段续写视频,靠 KV 缓存记住前面生成的世界,蒸馏版 8 步出片,INT8 量化后单张 4090 能跑。
山鲁佐德每天夜里给国王讲一个故事,讲到天快亮的时候停下,留一个扣子,第二天夜里接着讲。《一千零一夜》能讲下去,靠的不是哪一个故事特别精彩,而是讲故事的人始终记得昨晚讲到了哪里:谁还在山洞里,谁的灯还没擦,谁欠了谁一个承诺。故事一旦忘了前情,下一夜就只能重新开头,国王听腻了,讲故事的人也就活不成了。所以我一直觉得,会讲故事和会接着讲故事,是两门手艺,后一门更难。
这些年的文生视频,在我这个外行老狗看来,多半还停在第一门手艺上。你写一段话,它还你几秒画面,好看是真好看,可你要是想说「刚才那个房间,往左转一下,桌上的杯子换成红色」,它多半要从头再生成一遍,房间还是那个房间的样子,却已经不是那个房间了。每一次都是新的一夜,每一夜都从「从前有座山」讲起。
腾讯混元最近开源的 Hy-Nomas,想做的就是第二门手艺。据它在 Hugging Face 模型卡、GitHub 仓库和官网上的介绍,这是一个可交互的视频世界模型,不是一次性把视频生成完,而是一段一段地往下续写同一个世界。续写的时候,你可以改里面的物体、风格、动作,也可以塞进一条相机轨迹,让镜头往哪里走。中文媒体的报道见于 10 月 24 日。我对这件事感兴趣,不是因为它画得多漂亮,而是因为它把「记得前情」当成了正经的工程问题来对待。
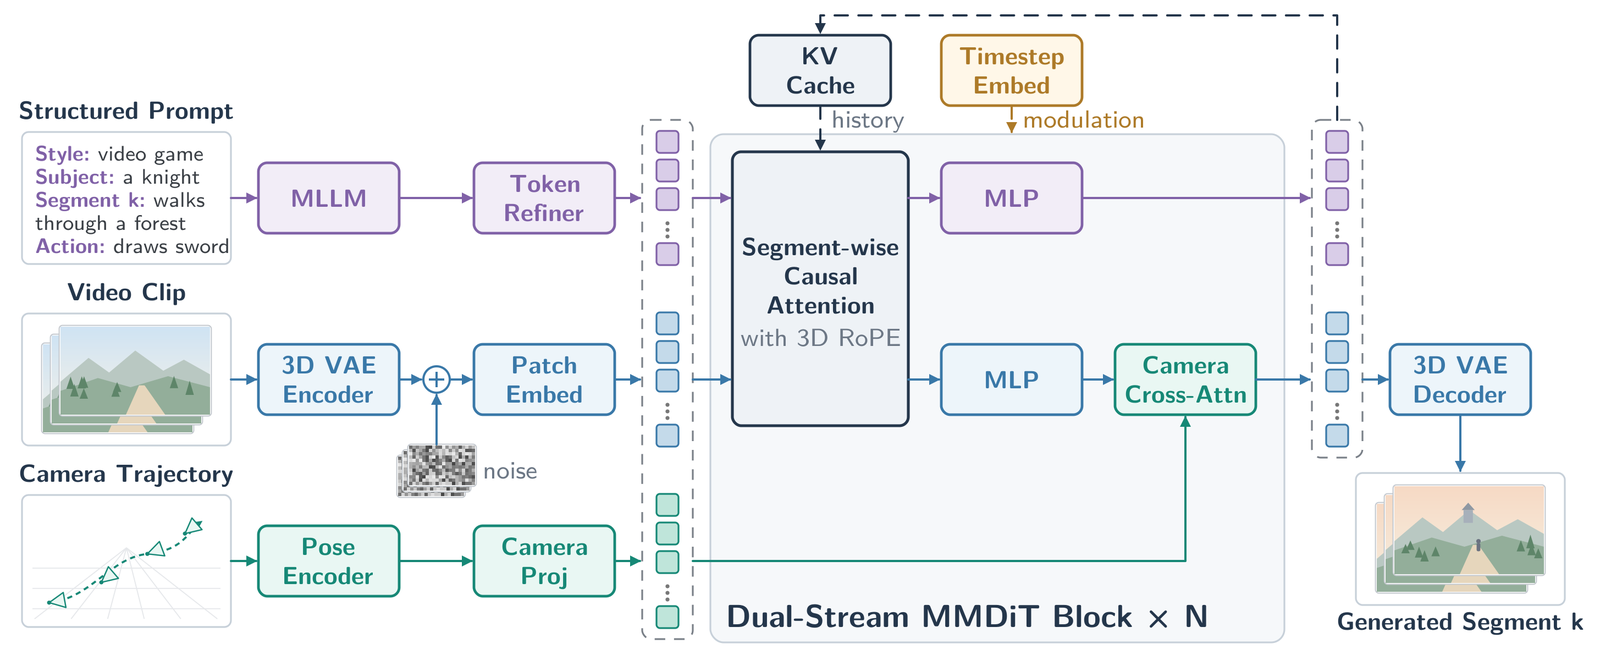
怎么记得前情呢?官方给出的结构是段式自回归的 DiT,配上 Qwen 的文本编码器、相机条件和 PixelUMM 解码器,段与段之间留着一份持久的 KV cache。说得土一点,就是讲故事的人每讲完一段,都把这一段的要紧处记在一本随身的小本子上,下一段开讲之前先翻一翻。这本小本子不是摆设,官方在单卡低显存的配置里专门写了一个「历史 GPU 预算」,默认是 18 个 latent frames,意思是本子能记多厚,是要算着来的。记得太少,世界会走样,记得太多,机器扛不住,这和人上了年纪以后的处境差不多,老狗对此深有体会。
文本这一路,据官方说,用的是 Qwen2.5-VL-7B-Instruct 里语言模型的那一部分,出来的 3584 维表示经过一个 refiner,再压到 2048 维,交给主干。主干是 54 个双流 MMDiT 块,hidden 2048,16 个头。这些数字我照抄在这里,不是为了显得懂行,而是想说明一件事:它并没有为了「续写」另起炉灶,造一个前所未有的怪物,而是把这几年大家已经熟悉的零件,按照「一段接一段」的规矩重新码放了一遍。很多时候,新东西就是旧零件换了个摆法,手艺人对此大概不会陌生。
我更在意的是相机那一路。官方写,相机条件走一个叫 extrinsics_attn 的模块,把归一化的 4×4 外参按 4 帧一组压成 64 维,视频 token 再对这些相机信息做 cross-attention。翻成人话,就是你告诉它镜头怎么动,它不只是在画面上做个平移的样子,而是让每一段画面都去「看一眼」镜头此刻在哪里、朝着哪里。一个世界之所以像一个世界,很大程度上在于你转身再转回来,东西还在原处。官方另外发了一个评测集 Hy-Nomas-Bench,四类共 280 例,分别是多轮文本、相机导航、交错控制和空间记忆。最后那一类的名字起得很老实,空间记忆,说的正是转身再转回来这件事。至于它在这个评测集上考得怎么样,那是腾讯自己出题自己考,听个大概可以,当定论还早。
推理上的安排也透着一股精打细算。据官方说,蒸馏后的模型推理只要 8 步去噪,默认输出 720×1280、24 FPS。标准配置默认要 8 张卡做序列并行,这显然不是给普通人准备的。好在另有一套单卡 RTX 4090 的低显存配置:DiT 和 KV 用 INT8,解码器用 FP8,再加上 CPU offload。这一段和前面的数字都是腾讯自己报出来的,没有经过独立验证,我也没有亲手跑过,不敢替它打包票说流畅不流畅,只能说,肯为一张消费级显卡单独写一套配置,至少说明做的人心里想着桌面上的那台机器,而不只是机房。
开源出来的东西不少,蒸馏版 DiT 有 FP32 和 INT8 两种,另有 base 自回归 DiT、一个 Cinematic LoRA、一个 Robotics LoRA,还有 DCAE-V 编码器和 PixelUMM 解码器及其 FP8 版本,许可证是 Apache-2.0。DCAE-V 的 latent 规格写作 f32t4c32,也就是 32 个通道,空间压缩 32 倍,时间压缩 4 倍。想自己动手的人,官方给了 Docker 镜像 hynomasoss/hynomasoss:cu130,也可以用 uv sync --extra all 装依赖。
「可交互」这个词,在这里也值得多看一眼。以前看视频,人是坐在台下的,导演拍什么你看什么。后来有了文生视频,人算是递上了一张点菜单,菜怎么做,还是厨房说了算。到了一段一段续写的时候,人就有点像是坐在山鲁佐德床边的那个国王了,听到一半可以插一句嘴,说这个人不该进山洞,镜头往东边看看,讲故事的人得接住这句话,还不能把前面讲过的忘掉。这对讲故事的人要求高了,对听故事的人其实也要求高了,你得知道自己想看什么。
那个 Robotics LoRA 值得多说一句。据官方资产清单,它是用 RealSource-World 的真实机械臂数据集训练的。这让我想起一个朴素的道理:机器人要学会在一个房间里干活,最好先在一个「记得住」的房间里练。如果每一次转身,桌子就挪了位置,杯子就换了颜色,那练出来的本事是不作数的。一个能续写、能记住空间的视频模型,在这里的用处,比拿来拍短片要实在得多。官方的说明是,把它合进蒸馏版 DiT,用来增强生成世界的机器人仿真能力。当然,眼下它只是资产清单里的一个 LoRA,像是给机器人仿真留的一个口子,至于这个口子将来能长成什么样,眼下谁也说不准,我也不打算替它画饼。
写到这里,难免要泼一点冷水,这是老狗的习惯。一个世界能续写,不等于这个世界就是真的。KV cache 记住的,是模型自己生成过的画面,不是物理世界的规律,它记得杯子在桌上,未必懂得杯子为什么不会自己飘起来。所以「世界模型」这四个字,我更愿意把它读成一种志向,而不是一份已经交付的成绩单。志向本身没什么不好,人总得先想着往哪里去,才可能走到那里去。
回到山鲁佐德。她讲了一千零一夜,后来国王不杀她了,不是因为某一个故事讲得惊天动地,而是因为一夜接着一夜,故事里的人和事都还在,听的人慢慢就住进去了。视频生成走到今天,画面好看已经不稀罕,稀罕的是明天接着讲的时候,昨天的房间还在,桌上的杯子还是那只杯子。能做到这一点,才算是开始讲一个世界,而不只是放一段烟花,句号。
来源:Hugging Face 模型卡;GitHub 仓库;官方项目页;ai123。许可证为 Apache-2.0;单卡 4090 方案需 INT8 DiT、INT8 KV 缓存、FP8 解码器和 CPU 卸载,标准配置默认 8 卡序列并行;Hy-Nomas-Bench(4 项、280 例)为腾讯自建评测,效果均为官方自报;Robotics LoRA 的前景为作者推测。