1024 个 Agent 没有经理:微软 Agensh 省下了谁的钱
微软开源多 Agent 协作框架 Agensh:最多 1024 个编码 Agent 不设经理,靠共享工作区、消息和共享上下文自组织;在 ProgramBench 最难的 5 道题上,平均通过率随 Agent 数量上升。
01
上班的人大概都懂一个道理。
一个团队干活慢,很多时候不是因为干活的人不够。
是因为所有的事,都得先过经理那一关。
经理就那么一个脑子。
一天就那么多时间。
你活干完了,得等他看。
他看不过来,你就只能等着。
人多了,等的人也跟着多。
这事儿放到 AI 身上,居然也成立。
现在多数多 Agent 系统,走的都是一个套路:主管拆活,工人干活。
主管是一个 Agent,手底下一群 Agent。
问题是,主管也只有一个上下文窗口。
窗口塞满了,它就看不过来了。
说白了就是,经理成了瓶颈。
10 月 24 日,微软开源了一个叫 Agensh 的项目,MIT 许可。
它干了一件很多老板想干、但不敢干的事。
把经理撤了。
不设 orchestrator,不设主管,所有 worker 用同一份 prompt,只差一个 ID。
然后让它们自己认领任务,自己商量,自己合并。
据微软自报,这套办法最多跑到了 1024 个 coding agent。
听起来很爽。
但这笔账,到底谁赚了?
我们一层一层扒。
02
先看它到底怎么干活。
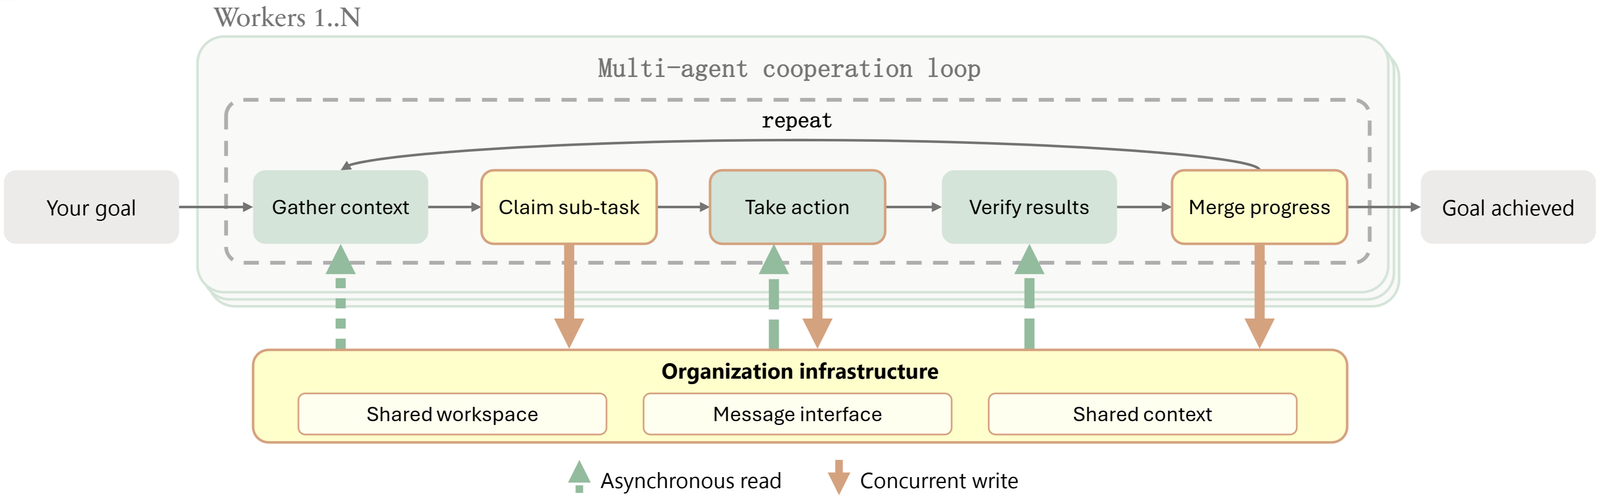
据微软仓库和论文(论文 9 月 22 日上的 arXiv,编号 2609.26781,标题是 Agensh: Scaling Organizational Intelligence to 1,024 Agents,作者里有 Furu Wei),每个 worker 都在跑同一个循环,一共五步。
第一步,收集上下文。
看目标是什么,同伴干到哪了,有没有人给我发消息,之前有没有人记下过什么发现。
第二步,认领一个子任务。
如果有人跟我撞车了,就跟它协商。
第三步,在本地用工具干活。
有发现就尽早分享出去,别闷着。
第四步,按验收标准自己检查一遍。
第五步,合并进共享仓库,发个更新,然后从头再来。
你品一品。
这五步里,没有一步是“向上汇报”。
也没有一步是“等领导批”。
那它们靠什么协调?
靠三个共享服务。
一个是 Gitea,管分支、PR,谁跟谁冲突了,大家都看得见。
一个是 Mattermost,有团队频道,也有紧急私信。
还有一个是共享的 context board,据仓库说明,这个思路来自 DeLM。
这块板子上记的是分门别类的笔记:观测到的行为、已经确立的事实、失败过的尝试、谁认领了什么、补丁摘要。
最有意思的是“失败过的尝试”这一栏。
做过风控的人都知道,最贵的不是犯错。
是同一个坑,不同的人轮流踩一遍。
这块板子,就是专门防重复踩坑的。
还有个细节很省钱。
这个循环是写在 prompt 里的,跑在现成的单 Agent harness 上。
实验里用的是 GitHub Copilot CLI agent。
论文的说法是,通过轻量的适配器,也能接到 Claude Code 这类单 Agent harness 上。
也就是说,它不是让你换一套新员工。
是给你现有的员工,发了同一本员工手册。
03
再看成绩单。
先说清楚,下面所有数字,都是微软自己报的。
测的是 ProgramBench 里最难的 5 道题:FFmpeg、gromacs、pandoc、PHP、ctags。
规则挺狠。
离线,不许上网查。
只能看程序的二进制行为和文档,然后把整个程序重建出来。
模型用的是 GPT-5.6-sol,开 high,每道题给 6 小时。
5 道题的平均分,据微软自报是这样涨的:
1 个 agent,19.31%。
8 个,20.68%。
32 个,26.52%。
128 个,28.78%。
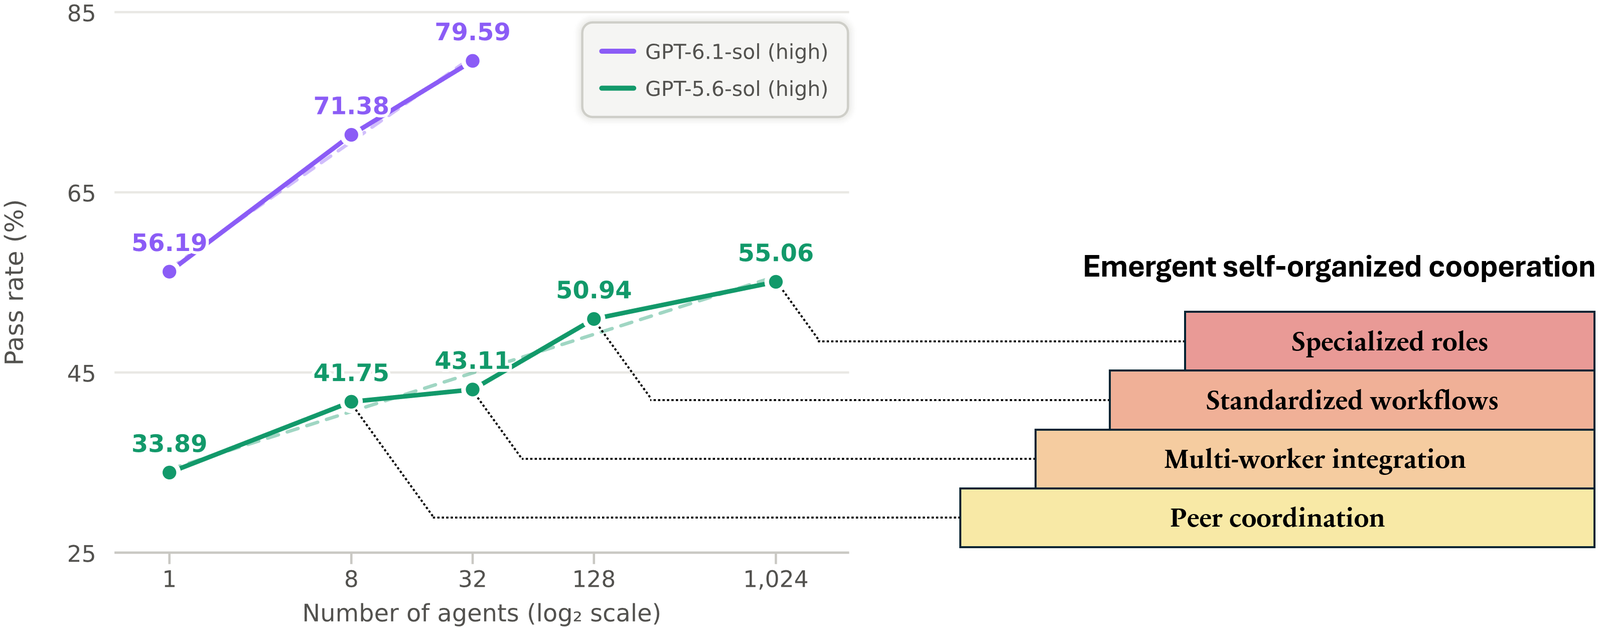
单看 pandoc 这一道,据微软自报:
1 个 agent,33.89%。
128 个,50.94%。
1024 个,55.06%。
速度上也有一组数,同样是微软自报:128 个 agent 用 30 分钟就过了 30%,32 个要 60 分钟,8 个要 90 分钟。
仓库里后来还加了一组新数据,换成 GPT-6.1-sol 做 pandoc,据微软自报,1 个是 56.19%,32 个是 79.59%。
数字是好看的。
但我比较在意的是另一件事。
这些 Agent 自己长出了“组织架构”。
据微软的说法,8 个的时候,它们会先约定接口再动手。
32 个的时候,出现了联合评审,PHP 那个案例里,有个 Agent 找到了反例,把已经给出的批准撤回了。
128 个的时候,它们开始按经验挑评审者,还形成了一套集成协议。
1024 个的时候,出现了好几个专职的 integrator,专门负责合并。
冒昧了。
经理撤了,最后又长出来一批管合并的。
说白了就是,活可以没有经理,但代码总得有人负责合进去。
这不是打脸,这是人间真实。
04
好,吹完了,该泼冷水了。
这盆冷水不是我泼的,是 AiLookout 那篇报道泼的,我觉得每一条都值得看。
第一条,论文没报成本。
1024 个 Agent 同时跑 6 小时,模型账单是多少?
没说。
讲道理,这是整件事里最关键的一行账。
不报成本的规模化,就像饭店只告诉你菜好吃,不告诉你价格。
好吃当然好吃。
问题是,你吃得起吗?
第二条,据 AiLookout,从 1 个加到 8 个,平均分只涨了 1.37 点。
也就是说,Agent 少的时候,加人不一定加效果。
第三条,据 AiLookout,单个 GPT-6.1-sol 的 pandoc 成绩,就已经超过了 1024 个 GPT-5.6-sol。
这句话我建议你多读几遍。
一个更强的员工,干过了 1024 个上一代员工。
那你说,老板是该多招人,还是该换个更好的人?
第四条,复现门槛不低。
这一条我对照了仓库里的复现指南(REPRODUCE.md),AiLookout 说的都对得上:你得有 Linux、Docker Engine 加 Compose v2、systemd、cgroup v2,脚本要求免密 sudo,还得自备一个模型网关,走的是 OpenAI 的 Responses API。
默认配置是 8 个 worker、每题 6 小时、prompt 窗口 272,000 token。
worker 的网络只放行访问模型的出口。
PR 可以零审批直接合并(只是不许直接推 main),CI 合并门禁是关着的。
后面这两条尤其要看清楚。
零审批合并、CI 关闭,在实验里是为了让它跑起来。
放到你公司的真仓库里,这就是事故现场。
所以 AiLookout 的定性很准:这是研究基建,不是产品。仓库本身也写明,这次放出来的是单机团队配置和单 Agent 基线,用来复现实验。
05
那这事儿到底有啥用?
我觉得它真正有价值的地方,是把“多 Agent 怎么组织”这个问题,换了一个问法。
以前的问法是,怎么找一个更聪明的经理。
现在的问法是,能不能不要经理。
对比一下市面上别的做法就清楚了。
据 AiLookout 的对比,Claude Code 的 agent teams 是固定一个 lead,带 3–5 个。
Kimi 的 Agent Swarm 最多 100 个子 Agent,但有 orchestrator。
都是有经理的。
Agensh 是少见的、把经理整个拿掉的那个。
顺便说一句,本站 10-25 那篇 AWS Infinity 讲的是大量 Agent 闲着等的时候怎么省内存,Agensh 讲的是大量 Agent 同时干活、还没人管的时候怎么不打架,两件事不是一回事。
那普通开发者该怎么看?
我的建议是,三个问题先问清楚。
你的活能不能拆成互不打架的小块?
拆不开,人越多越乱。
你的模型账单扛不扛得住?
论文没报成本,这笔账只能你自己去算。
你有没有比“加人”更便宜的办法?
比如换个更强的模型。
据 AiLookout,单个新模型就跑赢了 1024 个旧模型。
这三个问题想明白了,再决定要不要把仓库拉下来玩。
06
说回开头那个经理。
很多人看到这个项目,第一反应可能是:经理要失业了。
我倒觉得没那么简单。
Agensh 撤掉的,是那个什么都要过一遍的经理。
但它保留了共享仓库、共享聊天、共享笔记。
到了 1024 个的时候,还自己长出了好几个专职的 integrator。
说白了就是,它没有消灭管理。
它只是把管理从一个人的脑子里,搬到了大家都能看见的板子上。
这对人类公司也算是个提醒。
很多团队慢,不是因为缺一个更厉害的领导。
是因为信息只在领导一个人那里。
至于 Agent 要不要撤经理,等论文把成本那一行补上,再算也不迟。
只能说,AI 学人类开公司,学得比人类还快。
来源:GitHub 仓库(MIT);REPRODUCE.md 复现指南;AiLookout。论文 arXiv 2609.26781(2026-09-22),代码于 2026-10-24 开源;19.31%→28.78%、pandoc 33.89%/50.94%/55.06%、GPT-6.1-sol 56.19%→79.59% 等成绩及速度数据均为微软自报,未见第三方复测;复现环境要求据 REPRODUCE.md;接入 Claude Code 等工具为论文说法,本次开源默认用 Copilot harness;“省下了谁的钱”等成本分析为作者看法。