说得出来,还要指得出来:腾讯 WeVisOne-VL 把「看见」落到每一根头发丝
腾讯开源视觉语言模型 WeVisOne-VL(2B/4B):不接 SAM,用约 960 万参数的轻量解码器直接出检测框、分割 mask 和 alpha 抠图。
这几天 Hugging Face 的每日论文榜上,据 bitwidth 的每日汇总,10 月 24 日排第一的是腾讯微信团队的 WeVisOne-VL。我对榜单一向没有什么感情,榜单这种东西今天上明天下,比天气预报变得还快。但这一篇我多看了几眼,因为它想解决的问题很老派,老派到几乎不像是这个时代的问题:机器能不能不光说出它看见了什么,还能准确地指出来,指到哪个点、哪个框、哪一圈边缘,甚至哪一根头发丝。
人类小孩学说话,先学的是指。大人问「狗狗在哪里」,孩子伸出一根胖手指往窗外一戳,这件事就算完成了。会说「那是一只狗」反倒是后来的事。可是这几年的通用视觉语言模型走的是另一条路,它们先学会了说,而且说得头头是道,一张照片丢进去,能讲出一大段像模像样的描述,但你要它把那只狗框出来,它就开始支支吾吾,框得松松垮垮,或者干脆框到了旁边的沙发上。说得出来和指得出来,中间隔着的不是一层窗户纸,而是一整面墙。
WeVisOne-VL 的办法说起来不复杂。据腾讯在模型卡和项目页上的介绍,它基于 Qwen3-VL,把坐标也当成词表里的词,从 <0> 一直到 <1000>,一共 1001 个坐标 token。一个框用 4 个 token 表示,一个点用 2 个。这样一来,「指」这个动作就和「说」这个动作统一成了一件事,模型说话的时候顺手把位置也说了出来,不需要另外再学一门手艺。如果你问的东西图里根本没有,它就直接回答 None,不硬编一个框出来交差。
只会说坐标还不够,框只是一个粗糙的方盒子,真正麻烦的是边缘。官方的做法是在每个预测框后面跟一个特殊的实例 token,ID 是 152678,这个 token 一出现,就唤醒挂在后面的像素解码器。解码器文件叫 mask_decoder.pt,4B 版模型卡给出的参数量是 9,609,764,官方简写成 9.6M,也就是常说的约 960 万;2B 版用的那个稍小一点,模型卡写的是 9,511,460。它从视觉编码器里取四层 pre-merge 的 ViT 特征,用 6 层可变形 cross-attention 做查询,查询的依据是实例 token 的隐状态加上傅里叶编码的框先验,最后由一个密集头按 S/4 → S/2 → S/1 的顺序一级一级放大,出来一张全分辨率的 alpha 图。官方特别说明,这里不用 SAM,也不另外接一套分割骨干。
我尤其喜欢那个 None。这年头的模型最让人头疼的毛病,不是不会,而是不会还要装会,你问它图里的猫在哪,图里明明没有猫,它也要给你框出一团毛茸茸的阴影来,态度诚恳,言之凿凿。肯老老实实说一句「没有」,在我看来比多领先几个基准更难得。人也是一样,知道自己不知道,是手艺人入门的第一课,很多人学了一辈子也没毕业。
我这样的门外汉读到这里,感觉有点像看老木匠干活。先拿墨斗弹一条线,那是框;再顺着线用凿子一点点抠,那是像素解码器。线弹得准,凿子才知道往哪里走。框和边缘分成两步,但用的是同一双眼睛,不是请了两个师傅各干各的。于是在同一个模型里,点、框、mask、alpha 抠图都能出,检测、计数、OCR、分割也都放在了一个屋檐下。
当然,手艺不是凭空长出来的。据官方披露,训练用了约 1 亿张图,SFT 分三段:任务对齐 90.2M 样本,高分辨率与密集任务 40.5M,像素级 41.8M。之后再用 GRPO 做混合任务的强化学习,样本 178K。数据怎么来的也写得清楚,用知识图谱驱动采集,多个专家模型一起提框,VLM 负责校验,SAM2 负责把 mask 扩出来,再由专门的标注器出 alpha,模型犯的错回流到下一轮。官方自称在 30 多个基准上领先,按他们的写法是 30+,这些都是腾讯自己报的数,我没有看到第三方复测,读者也不必急着把它当成定论。
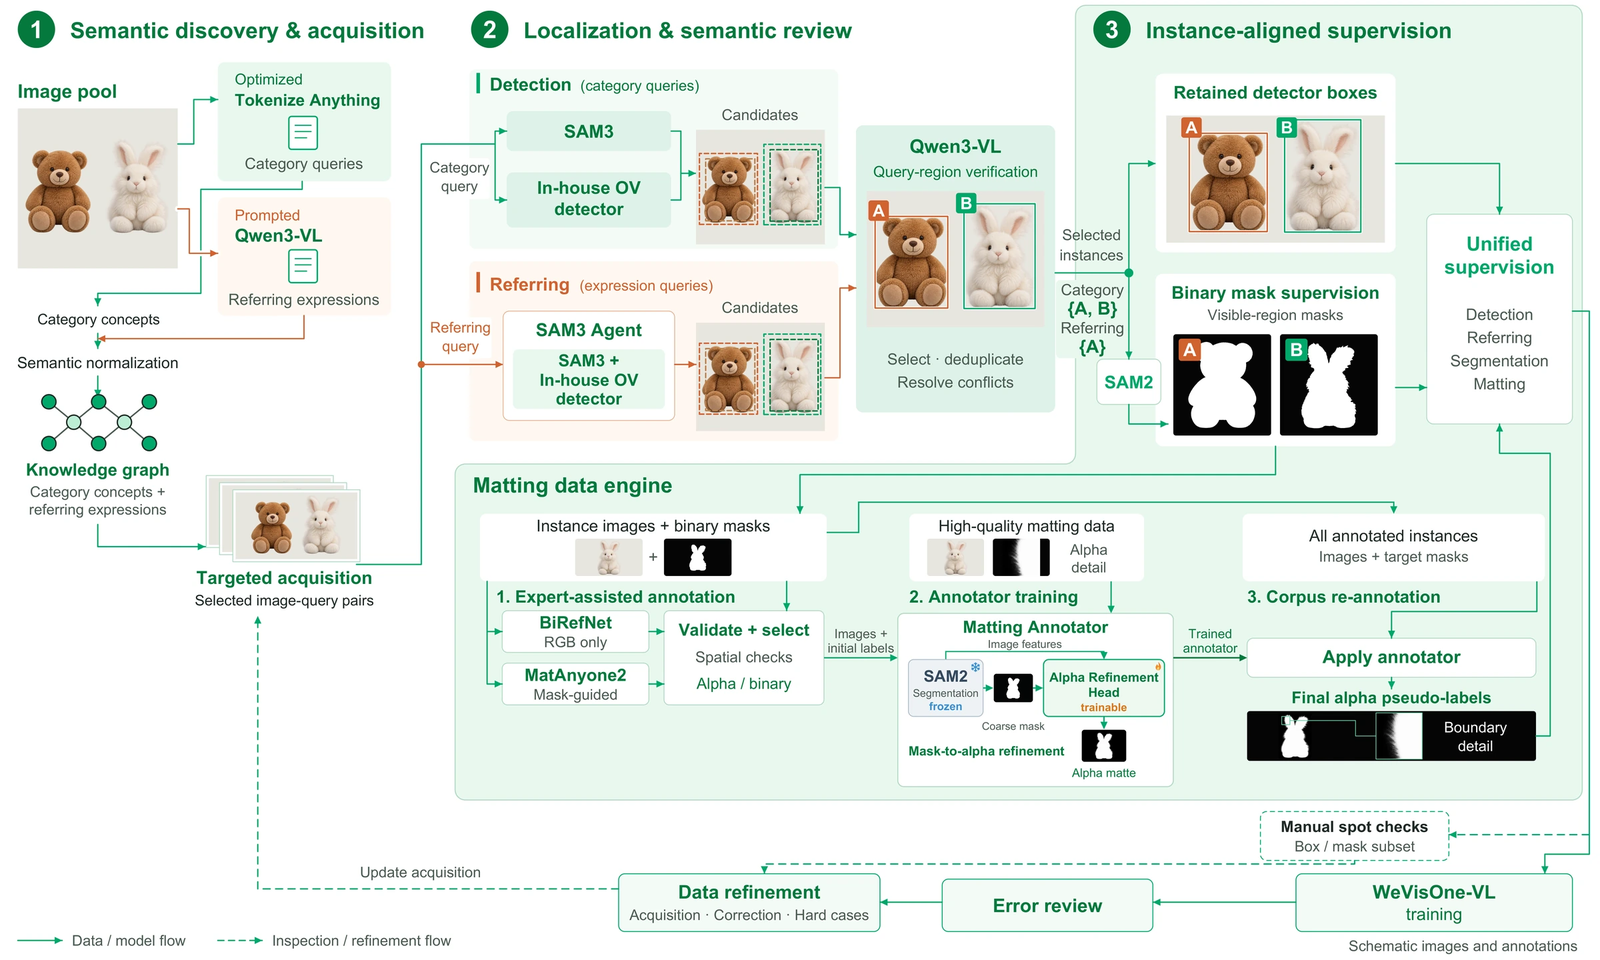
这里有一件小事值得多说一句。推理的时候不用 SAM,造数据的时候却用了 SAM2,这两句话放在一起并不矛盾,一个说的是模型本身怎么跑,一个说的是练习册是怎么编出来的。但我猜一定会有人把它们读串了,所以先摆在这里。
用起来倒是简单。官方给的示例就两行,from wevisone_vl import WeVisOneVL,然后 model.predict(image, task="matting", query="person"),告诉它任务是抠图,对象是人,它就去抠。官方没有给显存数字。我看了一下 Hugging Face 上的仓库文件,2B 版加起来约 4.9 GB,4B 版约 19.4 GB,这只是下载大小,不等于跑起来要的显存。两个版本都在 10 月 22 日上了 Hub,腾讯自己写的代码用 Apache-2.0 许可,第三方组件保留各自的许可证。
2B 和 4B 这样的个头,放在今天越堆越大的模型群里,算是小个子。小个子有小个子的好处,不需要供着一整排机柜,研究者自己手边的显卡就有机会跑起来。手艺不一定非要靠大块头,老师傅的凿子往往也不大,只是磨得快。
说到这里,我得把它不会的事情也讲清楚,这比讲它会什么更要紧。官方写明,它没有思维链,只能单轮、单图,像素解码器不接视频。细边缘的效果会受分辨率、遮挡和透明物体影响,头发丝能不能抠干净,要看照片本身给不给面子。更重要的一条是官方的使用声明:仅限研究用途,不用于识别个人,也不用于高影响的自主决策。
这条声明我觉得应该被认真读一读,而不是当成免责条款一眼扫过。一个模型能把照片里的人从背景里干干净净地剥出来,能在一群人里数出有几个人,能把每个人都框得严丝合缝,这种能力本身是中性的,可用的人不中性。假设有人拿它去对着街拍照片挨个圈人,模型不会拒绝,它只会忠实地给出坐标。所以「不用于识别个人」这几个字,约束不了机器,只能约束拿着机器的人。
那么,一个研究者拿到它,第一件事应该做什么?我的建议很朴素:先读模型卡,再跑示例,然后专门挑那些它会出丑的照片去试,逆光的、隔着玻璃的、头发被风吹乱的、主体被挡了一半的。官方已经告诉你它在哪里会失手,你自己再亲眼看一遍,心里才有数。别人说好用,和你自己用着好用,从来都是两回事。
我一向觉得,看见是一件很私人的事情。同样一张照片,有人看到的是人,有人看到的是光,有人只看到那只趴在角落里打盹的狗。机器的看见没有这些分别,它只看到它被要求看到的东西,而且越来越准。准本身是好事,准到每一根头发丝也是好事,前提是指挥它的那根手指,知道什么该指,什么不该指。
所以对于 WeVisOne-VL,我的态度和对待一把好凿子差不多。东西是好东西,开源出来让大家拿去研究,也是好事。但凿子在谁手里,往哪里凿,从来都不是凿子自己能决定的。机器学会了指,人更要学会不乱指,句号。
来源:官方项目页;4B 模型卡;2B 模型卡;Bitwidth。解码器参数 9,609,764 为 4B 版模型卡数字,2B 版为 9,511,460;4.9 GB / 19.4 GB 是 Hugging Face 仓库文件总大小,不是显存需求;约 1 亿张训练图、30+ 基准领先等均为腾讯自报;腾讯代码为 Apache-2.0,第三方组件保留各自许可;“推理不用 SAM、造数据用 SAM2”为作者对两条官方说法的解读。