Agent 的钱,大头花在翻旧账:清华 AKV 想让模型直接改自己的 KV 缓存
清华团队的 AKV 不改聊天记录,只改哪些 KV 缓存对注意力可见:论文自报对比按阈值摘要的基线,平均成本 -27.7%、分数 +1.7。
一
先说一个数字。
82.4%。
这是清华(外加一位港中文作者)的一篇论文里算出来的:在他们的成本分析里,KV 缓存读取,占了 API 总成本的 82.4%。
注意,这是论文自己的测算,而且论文里的成本,是按公开价格估算出来的 API 等效值,不是谁家真实的账单。
但哪怕打个折看,这个比例也很说明问题。
说白了就是,Agent 花的钱,大头不在“想”,在“翻旧账”。
为什么?
因为 Agent 干活,是一轮一轮来的。
每一轮,它都要把前面所有的聊天记录、工具返回、试错日志,从头到尾再过一遍。
活干得越久,旧账越厚。
旧账越厚,每一轮翻账的钱就越多。
二
那为什么不把旧账整理一下?
整理了。
业内这几年最流行的做法,叫上下文工程(context engineering):聊天记录太长了,就做个摘要,或者干脆截掉一段。
听上去很合理。
但问题是,这里面有个坑。
模型推理的时候,前面算过的东西,会存成 KV 缓存,下一轮直接复用,不用重算。
可这个缓存,认的是前缀。
你只要改了前面一个字,后面所有的缓存,全部作废,得重新 prefill,重新算,重新付钱。
所以你会看到一个很九转大肠的局面:
想省钱,就得整理记录;
一整理记录,缓存就废了,反而更费钱;
于是各家的 harness 只好憋着,憋到实在装不下了,才很晚、很粗暴地做一次摘要,中间的细节一刀切掉。
省钱靠憋,憋不住了就砍。
这哪是工程,这是硬扛。
砍掉的代价是什么?
举个假设的场景。
假设一个 Agent 在修 bug,前面试过一个方案,失败了,失败的原因写在一大段日志里。
后来上下文装不下,这段日志被摘要成一句话:“尝试过若干方案,未果。”
再往后,它很可能会把那个失败的方案,原封不动地再试一遍。
钱花了两次,坑踩了两次。
冒昧了,这种事,用过 Agent 的人大概都见过。
三
清华和港中文的这个项目叫 AKV,论文名叫《Cache Engineering for Agents》,arXiv 编号 2610.28577,代码在 GitHub 的 thu-nics/AKV,Apache-2.0 协议,基于 SGLang。
它的思路,一句话:
聊天记录一个字都不改,只改哪些 KV 条目对注意力“可见”。
站内 10-25 那篇 LangChain Deep Agents 讲的是在文本层收拾上下文,这篇是在 KV 层动手。
AKV 定义了三种操作:
Append,就是正常往后追加。
Drop,把指定的条目从后续的注意力里拿掉,但位置不动。
Repos,用 RoPE 旋转,把留下来的 key 重新排到 0 到 r-1 的位置上;value 不变,也不用重算。
打个比方。
文本层的做法,是把账本撕掉几页,再誊抄一份新的。
AKV 的做法,是账本不动,在不想看的那几页上贴张条“这页跳过”,必要的时候,再把剩下的页码重新编一遍。
账本还是那本账本,缓存也就还能用。
四
光有想法不够,服务端得接得住。
据论文和仓库说明,AKV 在服务端做了两件事:
一是扩展了 SGLang 的 radix tree,加上 drop 和 reposition 节点。这样一来,同样的 token、但操作历史不同的两段缓存,就不会被错当成一回事拿去复用。
二是用 segment-batch attention,一次 prefill 就能恢复被驱逐的状态。
对开发者来说,接口长这样:无状态,兼容 OpenAI 的格式,只多了两个可选字段,drop_message 和 reposition。官方给的例子是:
{"drop_message":{"4":[2]},"reposition":[4]}
再往上,还有两层封装。
CachePolicy,可以按轮次、按 token、按模型来触发清理。
CacheTool,更有意思,它让模型自己调用 drop_context,自己决定忘掉什么。
讲道理,让模型自己决定“哪些旧账可以不看了”,这个权力交出去,是一件需要想清楚的事。好处是它最懂自己在干什么,风险是它也可能把后面要用的东西提前扔了。
五
好,算账时间。
以下全部是论文自报的数字。
实验是 3 个模型(GPT-OSS-120B、MiniMax-M2.7、MiroThinker-1.7-Mini)乘 4 个基准(BrowseComp-Plus、GAIA-Text、SWE-bench Verified、xbench-DeepSearch-2510)。
对比的基线叫 Standard,也就是上下文涨到阈值才做摘要(GPT-OSS-120B 和 MiniMax-M2.7 是 96K,MiroThinker 是 192K)。和它比,AKV 平均成本 -27.7%,分数 +1.7。
还有一条基线叫 Text Engineering,把摘要阈值压到 48K,勤快地在文本层整理。和它比,AKV 平均成本 -21.9%。
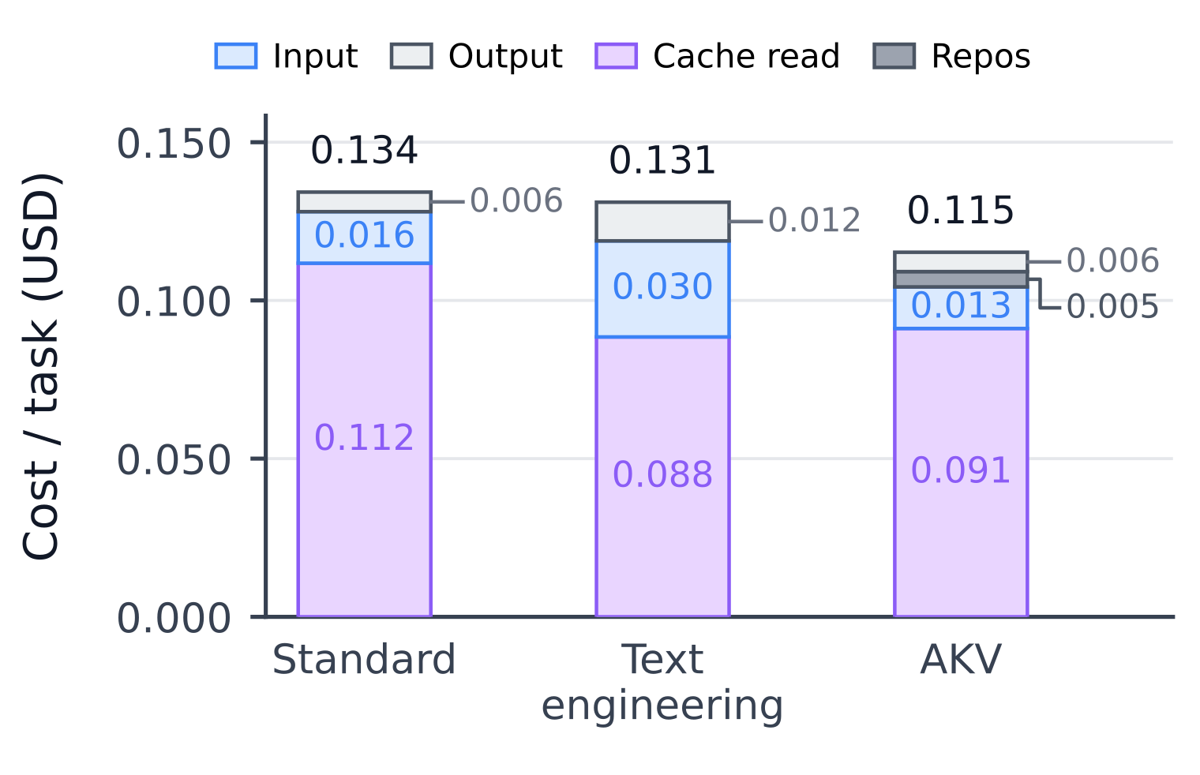
举一组:GPT-OSS-120B 在 SWE-bench Verified 上,和 Standard 比,单任务成本从 20.0 美分降到 9.7 美分,分数从 40.0 到 43.2。
输的一组也写出来了:MiniMax-M2.7 在 BrowseComp-Plus 上是 58.9,比 Text Engineering 的 62.3 低 3.4。
延迟方面,论文给的并发 16 那一档,P95 延迟从 Standard 的 229.90s 降到 30.63s。
单看 Repos 这一招(消融实验,只跑了前 100 道题),GPT-OSS-120B 在 BrowseComp-Plus 上从 55% 到 62%。
我比较欣赏的一点是,论文把输的那一组也摆出来了。
这年头,敢把自己最难看的成绩放进正文的论文,不多。
但也要冷静:这些成本都是按 Groq、MiniMax 等公开价格算出来的 API 等效估算,不是生产环境里跑出来的真金白银;分数也都是作者自己测的,还没看到第三方复现。
六
最后,问一个按计算器按到冒烟的问题:
这钱,省给谁了?
先看门槛。据仓库说明,AKV 目前只支持 Qwen、GPT-OSS、MiniMax-M2 这几类文本模型。论文实验用的是 8×A800-80GB,quick start 用 2 张卡跑 GPT-OSS-120B。
也就是说,这是给自己部署推理服务的人准备的。
你要是只调闭源模型的 API,KV 缓存在人家机房里,你够不着。
当然,闭源厂商以后会不会在自己的服务里用上类似的思路,那是另一回事。论文里没说,我也不替人家说。
能确定的只有一点:开源、能自己部署,这件事的价值,又多了一条理由。
所以我的看法是(这是我的推断,不是论文的说法):
短期内,能直接吃到这口肉的,是自己跑开源模型的团队,以及做推理服务的厂商。
对前者,省下来的是自己的算力和电费。
对后者,省下来的成本,最后是让利给用户,还是留在自己的毛利里,就看竞争够不够激烈了。
而对普通开发者来说,这件事最大的意义,也许是换了一个问题的问法:
过去大家问的是,聊天记录太长了,怎么删?
AKV 问的是,聊天记录可以不删,模型能不能学会不看?
删,是要付钱重算的。
不看,可以不用。
省钱的尽头,原来是学会忘记。
来源:arXiv 2610.28577 论文;GitHub 仓库(Apache-2.0);官方项目页。82.4%、-27.7%、-21.9%、P95 延迟等均为论文作者自报;成本是按 Groq、MiniMax 等公开价格算的 API 等效估算,不是真实账单;Repos 的 55%→62% 来自只跑前 100 题的消融实验;支持模型与部署要求据仓库 README;“这钱省给谁了”为作者推断。