几百页的文档,AI 终于不用越读越慢了?聊聊百度 Unlimited-OCR 2
百度开源约 3.3B 参数的 Unlimited-OCR 2,用 SR-SWA 让长文档解码每步的延迟和显存基本恒定;成绩为论文自报,“整套小说”之说模型卡里没有。
一份几百页的年报扔给 AI,它先累的是哪儿?
眼睛吗?
不是。
是记性。
说白了,现在的模型读长文档,有点像一个人边抄书,边回头翻前面的每一页。
抄得越多,回头翻得越久。
抄到后面,每写一个字,都要把前面所有的页再扫一遍。
你说它能不慢吗?
这就是长文档 OCR 一直绕不过去的那道坎。
10 月 27 日,百度在 Hugging Face 上放出了 Unlimited-OCR 2。
它想干的事,就是让 AI 抄书的时候,别老回头翻了。
1
先说它到底改了什么。
官方模型卡上,核心技术叫 SR-SWA。
全称 Sparse Reference Sliding Window Attention。
名字很长。
意思不复杂。
就是每一步解码的时候,文本对图像的注意力,只盯着一个固定大小的“工作参考集”。
模型卡举的例子是 512 个 token。
前面不管已经处理了多少页,这个参考集的大小都不变。
那会怎样?
官方的说法是,每一步解码的延迟和显存,基本恒定。
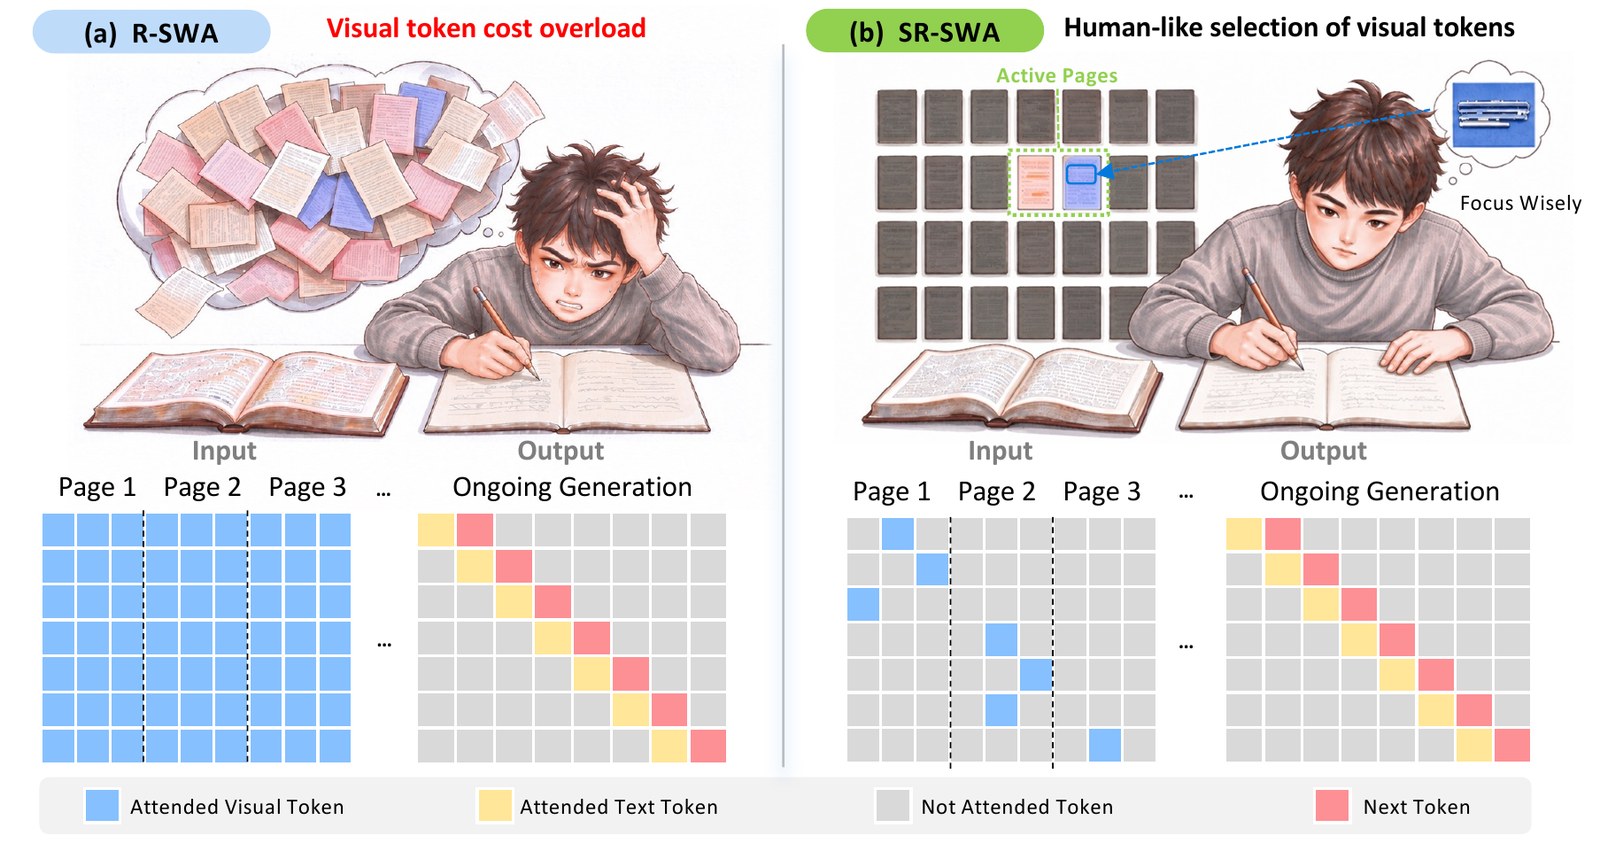
再配上一个叫 Unlimited-Horizon Decoding 的解码方式,就是他们说的“无限长度”解析。
打个比方?
以前是边抄边翻整本书。
现在是只盯着正在抄的那一段,手边再放几张便签。
书再厚,桌面上摊开的东西也就这么多。
这个比方未必精确,但大意就是这样。
2
那效果呢?
论文自报的数字是这样的。
百页规模下,单步解码比 Full Attention 快 7.0 倍,比 R-SWA 快 5.6 倍。
注意这里说的是“单步解码”。
就是模型每往外生成一个 token,要花的那点时间。
它不等于整份文档从头到尾处理完的总时间。
这两个数,别混着用。
更别拿 7.0 倍去推算“我的文档能快多少”。
论文没这么说,我也不会这么算。
在 MPDocBench 上,论文自报总分 84.59,排第一。
看到这儿,你是不是觉得稳了?
别急。
MPDocBench 最长是 30 页。
也就是说,84.59 这个分数,讲的是 30 页以内的表现。
那百页级别呢?
百度同时发布了一个新的百页级基准,叫 MarathonDocBench:100 份文档,每份 103 到 300 页。论文里 Unlimited-OCR 2 在上面的成绩是 77.06。
自己出卷子,自己考试?
冒昧了,我不是说它作弊。
我是说,一把新尺子刚做出来,得等别人也拿去量一量,才知道这把尺子准不准。
所以,上面这些数字,目前都是百度论文和模型卡自报的。
我没有看到第三方的复现。
3
我们来算账。
做一件事,看四样东西:目标、成本、收益、风险。
目标很清楚。
合同、年报、档案、整本书,这些长文档,一次解析完,还要保住跨页的上下文。
为什么跨页上下文这么重要?
因为一张表,可能从这一页跨到下一页。
一个条款,可能在前面定义,在后面引用。
一页一页拆开识别,单页都对,拼起来可能就不对了。
模型卡上也有对应的设计。
用 Transformers 跑的话,有个 infer_multi,多页放在一次请求里,用的就是跨页上下文。
成本呢?
Hugging Face 页面按权重文件统计,约 3.3B 参数。
权重是 BF16 的 safetensors。
3B 级别是什么概念?
就是说,它不是那种动不动要堆一排显卡的巨型模型。
部署门槛,相对低。
收益呢?
如果延迟和显存真像官方说的那样基本恒定,那长文档就不用为了显存,被切成一小段一小段地喂。
注意,我说的是“如果”。
风险呢?
放到最后说。
4
那么问题来了。
谁最需要这个东西?
我冒昧猜一下。
不是普通用户。
普通用户拍一张发票,识别一下,单页 OCR 早就够用了。
真正头疼的,是那些天天和一摞一摞纸打交道的地方。
审合同的。
看年报的。
管档案的。
做尽调的。
这些人的痛点是什么?
不是“认不出字”。
是“认出来了,但前后对不上”。
前面定义的名词,到后面引用的时候,系统还记不记得?
表格的表头在上一页,数据在下一页,系统能不能拼回去?
以前的办法是什么?
切。
把长文档切成一段一段,分别识别,再让人或者另一个程序去拼。
切的地方,就是出错的地方。
所以,Unlimited-OCR 2 真正想卖的,说白了不是“快”。
是“不用切”。
当然,这是它的设计目标。
它在真实的合同和档案上做得怎么样,模型卡给不了答案,得用的人自己测。
5
先说几个用之前要注意的地方。
第一,需要 trust_remote_code。
说白了,就是要运行仓库里自带的自定义代码。
做风控的人,看到这个参数,第一反应应该是什么?
先看代码,再跑。
在公司内网用,最好先过一遍安全审查。
第二,怎么跑。
模型卡给了两条路。
一条是 Transformers,适合自己先试,多页文档用 infer_multi 一次送进去。
一条是 SGLang,官方推荐用来做服务化部署。注意,用的是仓库里给的定制版 SGLang wheel,不是官方原版。
区别在哪?
前者像在自己家厨房做饭,做给自己吃。
后者像开饭馆,要接很多桌客人。
如果你只是想看看效果,前者够了。
如果你打算把它接进公司的业务流程,那就走 SGLang。
模型卡上还给了 SGLang 下页窗口调度的环境变量。
模型卡的示例里,max_page_tokens(每页输出 token 上限)设的是 20000。
第三,许可。
Hugging Face 模型卡上标的是 MIT。
MIT 很宽松,对商用友好。
但我的建议是,商用之前,还是让法务把仓库里的许可和那个定制 wheel 一起过一遍。
标签是标签,合规是合规。
第四,想先试试的,ModelScope、百度智能云、HF Space 的 demo,都能用。
6
最后说风险。
也就是泼冷水。
这几天 X 上流传着一些说法,说它能一口气处理整套好几部的长篇小说。
听着很燃,对吧?
官方模型卡上,确实放了一段演示回放,标的是“单次请求解析一整本书”。
但注意两点。
一是,那是一本,不是一整套。“整套”的说法,模型卡里没有。
二是,那是官方挑出来的演示,不是评测成绩。
网传的东西,不能当成能力。
演示也不能。
还有准确率。
网上流传着这个系列的一些准确率数字。
aiholics 自己在报道里提醒,这些数字要谨慎看待。
所以,我在这里一个都不引。
为什么这么较真?
因为 OCR 这件事,错一个字,可能就是错一个金额。
合同里的一个数字认错了,后果谁来扛?
模型吗?
不会的。
是签字的那个人。
所以,你要分清楚两件事。
“能读多长”是一回事。
“每一页都对”是另一回事。
前者解决的是读不读得完。
后者解决的是信不信得过。
一个长文档 OCR 工具,最后拼的不是能读多长,而是读到最后一页,还准不准。
这个问题,只有拿你自己手里的真实文档去测,才有答案。
7
顺便交代一下背景。
初代 Unlimited-OCR 是 2026 年 6 月 22 日发布的。
当时的定位,是“把 DeepSeek-OCR 再往前推一步”。
这一次,是第二代。
那这事跟普通人有什么关系?
你想想,多少扫描件、档案、老合同,还压在柜子里,搜不到,也查不着?
如果长文档解析真的变便宜了,它们就有机会变成能搜索的文字。
至于能不能真的做到,还得看大家实测。
一个模型,敢把名字叫“无限”。
只能说,我爱这个魔幻的世界。
来源:Hugging Face 模型卡(MIT);技术论文;MarathonDocBench。参数量与许可据 Hugging Face 页面;7.0×/5.6× 为单步解码加速,84.59、77.06 等分数均为论文自报,未见第三方复现;模型卡中的“单次请求解析一整本书”是官方演示回放,不是评测;网传准确率数字不予引用。