留一块老面:蚂蚁把 Ling-3.1-flash 的底座也放出来了
蚂蚁 inclusionAI 放出 Ling-3.1-flash-1019 和底座 Ling-3.1-flash-base(均 MIT):560B 总参、25B 激活;仓库约 574 GB,1M 上下文与 config 不一致,示例路径也要自己改。
会蒸馒头的人都知道「老面」这回事,上一锅发好的面团揪下一块,留着,下回和面的时候掺进去,面就能发起来,蒸出来的馒头带着自家的味道。去超市买一袋现成的馒头当然省事,可那是别人家的味道,你想改都无从下手;手里有一块老面就不一样了,想做馒头做馒头,想做花卷做花卷,想多加点碱也由着你,只是得自己和面、自己等它发、自己守着火候,蒸坏了也怪不着别人。老狗这几天看开源模型的发布,脑子里转的就是这个画面,因为蚂蚁这次除了端出一笼蒸好的馒头,还顺手把老面也递了过来。
事情是这样的。蚂蚁的 inclusionAI 在 Hugging Face 上放出了 Ling-3.1-flash-1019,按模型卡的说法,这是 Ling-3.1-flash 的后训练升级版;前后脚放出的,还有一个叫 Ling-3.1-flash-base 的底座模型,按它自己的模型卡,这是 Ling-3.1-flash 的底座 checkpoint(是 Ling-3.1-flash 的,不是专为 1019 做的),训练时用的是 FP8,放出来的是 BF16 权重。时间上有个小小的错位,Artificial Analysis 记的发布日是 10 月 22 日,而 Hugging Face 上显示,base 的仓库 10 月 25 日建起来,1019 的仓库到 10 月 27 日才有,所以你要是在 22 号就听说了它,却到 27 号才下载得到,并不是你的网有问题。
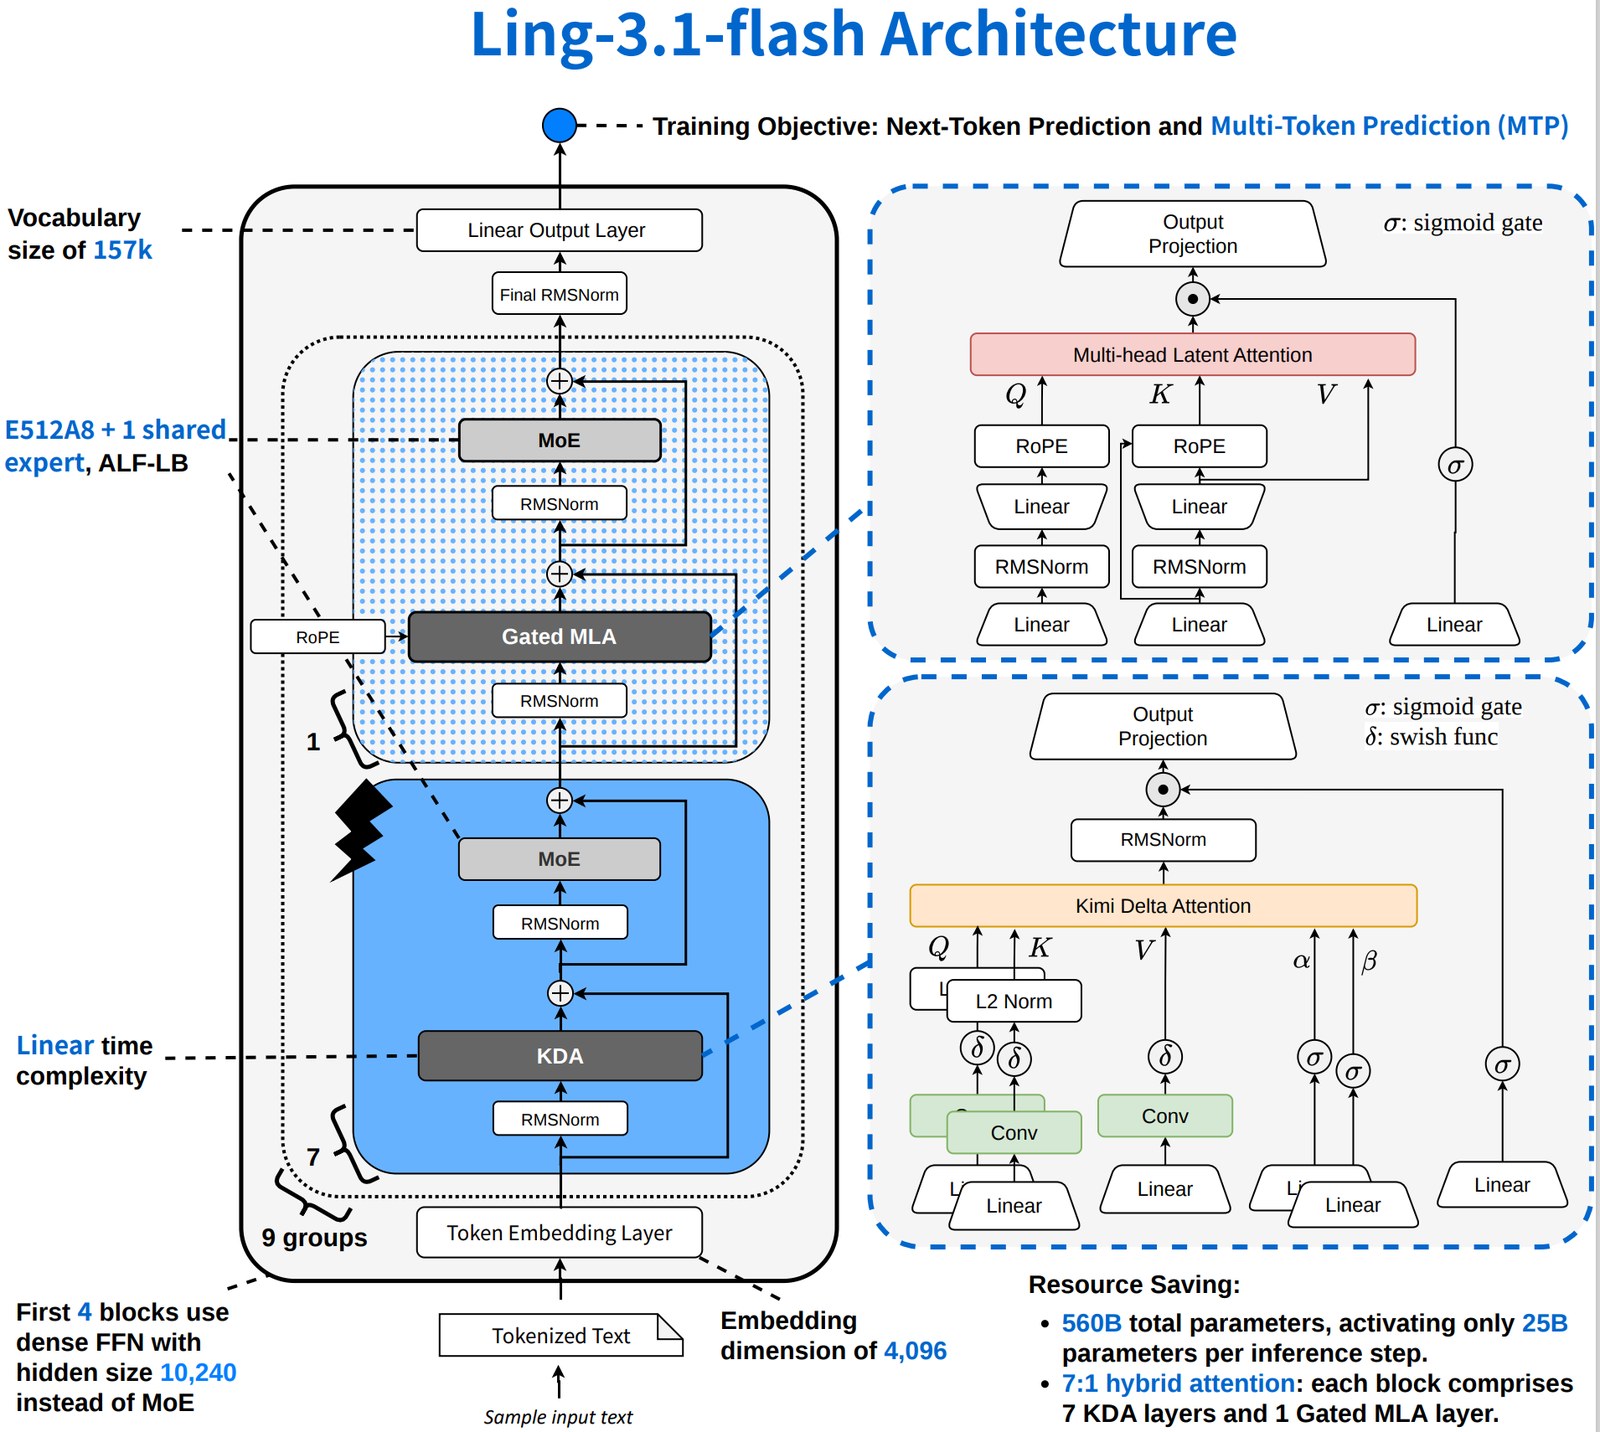
先说这笼馒头。模型卡自报的规格是总参数 560B(Hugging Face 侧栏按权重文件自动统计出来的是约 572B,两边不完全一样,官方没解释,老狗这里按模型卡写),每个 token 激活 25B,结构是所谓混合线性 MoE:63 层 KDA 加 9 层 Gated MLA,比例 7:1,专家方面是 512 个路由专家加 1 个共享专家,每次激活 8 个,许可证是 MIT。这些名词对普通读者来说大概像菜谱上的「少许」「适量」,看了也不知道到底放了多少,老狗也不打算在这里逐个解释,只说一句大白话:这是一个块头很大、但每次只动用其中一小部分的模型,设计的心思主要花在「怎么在长上下文里不那么费劲」这件事上。至于实际费不费劲,那是要在你自己的机器上跑过才知道的。
然后是成绩。模型卡自报了一组升级前后的对比:AA-Briefcase 的 Elo 从约 1400 到 1524,AutomationBench-AA 从 62% 到 68%,CritPt 从 18% 到 26%,SciCode 从 54% 到 57%,Artificial Analysis Intelligence Index v4.3.2 从 41 到 44。这一串数字老狗照抄在这里,一个字都没改,也一个都不打算替它往外推,因为它们全是厂商自报的,而且说的都是「比升级前好了一些」,不是「比别人好了多少」。看榜单这件事,老狗的态度一向是,数字可以看,但别拿它当体检报告,它更像是厨师自己写在菜单上的推荐语,你点不点,还得尝过再说。
接下来要泼点冷水了,而且是很实在的冷水。第一盆是体积。这不是一个能放进笔记本的模型,Hugging Face 上整个仓库约 574 GB,权重大多是 FP8。官方推荐用 SGLang 部署,给了专门的镜像 lmsysorg/sglang:dev-ling-3.1-flash,示例是 8×H200,TP8 加 EP8,再开 NEXTN 投机解码,模型卡也称 4×GB300 可以跑;用 vLLM 的话是 TP8。推荐的采样参数是 temperature 1.0、top_p 0.95、top_k 20,并且打开 thinking,也就是 enable_thinking。说白了,这是给有机房的人准备的,家里只有一台游戏本的朋友,看看热闹就好,别动下载的念头,硬盘和电费都会教你做人。
第二盆是上下文长度。模型卡上写的是 1M 上下文,但 llms.blog 指出,config.json 里的 max_position_embeddings 是 262,144,老狗也去 config.json 里看了一眼,确实如此。这两个数对不上,老狗也没本事替官方解释到底是怎么回事,也许另有扩展的办法,也许只是文档没对齐,总之你要是打算拿它做长文档的活,部署之前务必自己核对一遍,别看到「1M」三个字就把整本合同往里塞,塞进去出了问题,也没有人会替你担着。
第三盆最琐碎,但最容易让人骂娘。模型卡里 SGLang 的示例命令,模型路径还写着旧的 inclusionAI/Ling-3.1-flash,你要是照抄,拉下来的就是旧版本,得自己改成 inclusionAI/Ling-3.1-flash-1019;客户端请求里的 model 名也还写着 Ling-3.1-flash,一并留意。这种事情在开源圈里太常见了,文档总是比权重晚一步,复制粘贴的人总是比看文档的人多一步,两者一叠加,就是一个下午的排查。老狗的建议很朴素,任何一条从模型卡上抄来的命令,跑之前先把路径和版本号念一遍,念出声来那种。
好,冷水泼完,回到那块老面。这次发布里,老狗觉得最值得说的其实不是 1019 本身,而是那个 base 模型。很多模型发布,只给你蒸好的馒头,也就是对话版、指令版,底座是不给的;你可以吃,可以评价咸淡,但没法拿它去发自己的面。蚂蚁这次把 Ling-3.1-flash-base 也放了出来,官方列的用途是继续预训练、mid-training、领域 SFT、偏好优化和 RL、蒸馏,以及长上下文和 MoE 方面的研究。翻译成厨房里的话,就是你可以往这块面里掺自己的料,揉成自己的形状,发成自己想要的样子,最后蒸出来的东西,是你自己的。
但老面不是馒头,这一点官方自己说得很清楚:不建议把 base 模型直接拿给终端用户聊天,也不建议不经后训练和针对性验证就上生产,更不建议不加对齐和评测就用在安全攸关的场景。这话听着像免责声明,其实是句大实话。底座模型没有经过对话方面的调教,它不知道该怎么回应一个普通人的问题,也没有经过安全方面的打磨,你把一块生面团直接端上桌,客人咬一口,难受的是客人,丢人的是你。想要用它,就得老老实实地做后训练,做评测,做安全,这些功夫一样都省不了,省了就等于把生面团端上了桌。
那么,谁真正需要这块老面?老狗想来想去,大概是这么几类人:手里有大量行业数据、想要一个「懂自己行当」的模型的公司;做模型研究、想看看 MoE 和长上下文到底是怎么回事的实验室;还有想拿大模型去蒸馏小模型的团队。对这些人来说,一个 MIT 许可、能自己继续训练的底座,比一个榜单上多几分的对话模型要值钱得多,因为分数是别人的,底座练出来的东西才是自己的。对其他人来说,老实说,这块老面你拿回家也没地方发,它需要的那口锅,比你家的厨房还大。
老狗写到这里,想起开源这件事这些年的一点变化。早些时候大家争的是「开不开源」,后来争的是「开源到哪一步」,权重给了,训练数据不给;对话版给了,底座不给;许可写着开源,条款里藏着限制。所以每次看到有人把底座也一起放出来,许可证还是 MIT 这种宽得不能再宽的,老狗心里还是会觉得,这是一件值得记一笔的事。当然,记一笔归记一笔,上面那三盆冷水该泼还是要泼的,574 GB 的体积、对不上的上下文长度、过期的示例路径,哪一个都比榜单上的分数更贴近你真正动手那天会遇到的事。
馒头好吃,人人都会说;老面难养,得自己守着。蚂蚁这次把老面递了过来,能不能发起来、发成什么样,就看接过去的人肯不肯花那个功夫了,不是么?
来源:Ling-3.1-flash-1019 模型卡;Ling-3.1-flash-base 模型卡;config.json。所有成绩为模型卡自报的升级前后对比,未见第三方复测;560B 据模型卡,Hugging Face 按权重文件统计约 572B;max_position_embeddings 262,144 据 config.json;Artificial Analysis 记的 10-22 发布日未核实;base 的推荐与不推荐用途据其模型卡。