12.7 倍?先别急,Liquid 的 LFM3 这笔账得这么看
Liquid AI 发布 LFM3 系列,一个约 2B 底座拆成文本、视觉、语音、omni 和扩散等六个开放权重小模型;媒体标题里的“12.7 倍”是拿两个官方自报分数相除得来的。
这两天刷到一个标题。
大意是:Liquid AI 发布 LFM3,agent 基准提升 12.7 倍。
12.7 倍。
冒昧了,我第一反应是:真的假的?
一个小模型,agent 能力直接翻这么多倍,那大模型还卷什么?
点进去一看。
这个 12.7 倍,是媒体自己的口径。
techtimes 拿 Liquid 官方给的两个数一除,就成了标题。
官方给的原始数字是这样的:
WebArena-Verified 上,LFM3-1.7B 得 38.42,LFM2.5-2.6B 得 3.02。
说白了就是,上一代在这个测试上基本没怎么做对,这一代能做对一部分了。
这是进步吗?
当然是。
但“基本不会”到“会一些”,和“已经很强、再强好多倍”,是两回事。
所以这篇不聊倍数。
聊点更实在的:这东西到底给谁用,用起来要花什么。
01
先说它是什么。
据 Liquid AI 在 Hugging Face 的官方博客,10 月 27 日,Liquid 发布了 LFM3 系列,媒体 10 月 28 日跟进报道。
一共六个模型。
都是从同一个底座 LFM3-1.7B-Base 分出来的。
LFM3-1.7B,管文本。
LFM3-VL-2B,管图像和视频。
LFM3-Audio-2B,管语音,能听也能说。
LFM3-Omni-2B,全模态,官方说是他们第一个 omni 模型。
还有两个比较特别的:d1-2B 和 d1-omni-2B。
它们能一次前向回答多个结构化问题,还会给出校准过的概率。
全部开放权重,transformers 就能跑。
有意思的是什么?
大家都在比谁的模型更大更全能的时候,Liquid 反着来。
一个底座,按模态拆成好几个专用小模型。
你要看图,就拿看图的那个。
你要听声音,就拿听声音的那个。
不用为了一个功能,把一整个全能模型搬上手机。
这对开发者意味着什么?
意味着你可以按需付“内存税”。
只做语音助手的,就不用为看图的那部分买单。
只做收据识别的,就不用为听声音的那部分买单。
真要什么都做,再上 Omni。
站内之前写过 LFM2.5 的 24B 版本,那是往大里做,这次是往小里拆。
02
为什么要这么拆?
因为它想去的地方,是手机、树莓派、NPU。
这些地方,最贵的不是钱,是内存和电。
官方说,4-bit 量化后大约 1 GB。
做架构搜索的时候,硬件在环,覆盖了 14 种设备和后端:手机、树莓派 5、笔记本、云上的 CPU 和 GPU、高通 Hexagon NPU。
架构是 24 层“三混合”:13 层门控短卷积,5 层滑窗注意力,6 层全局注意力。
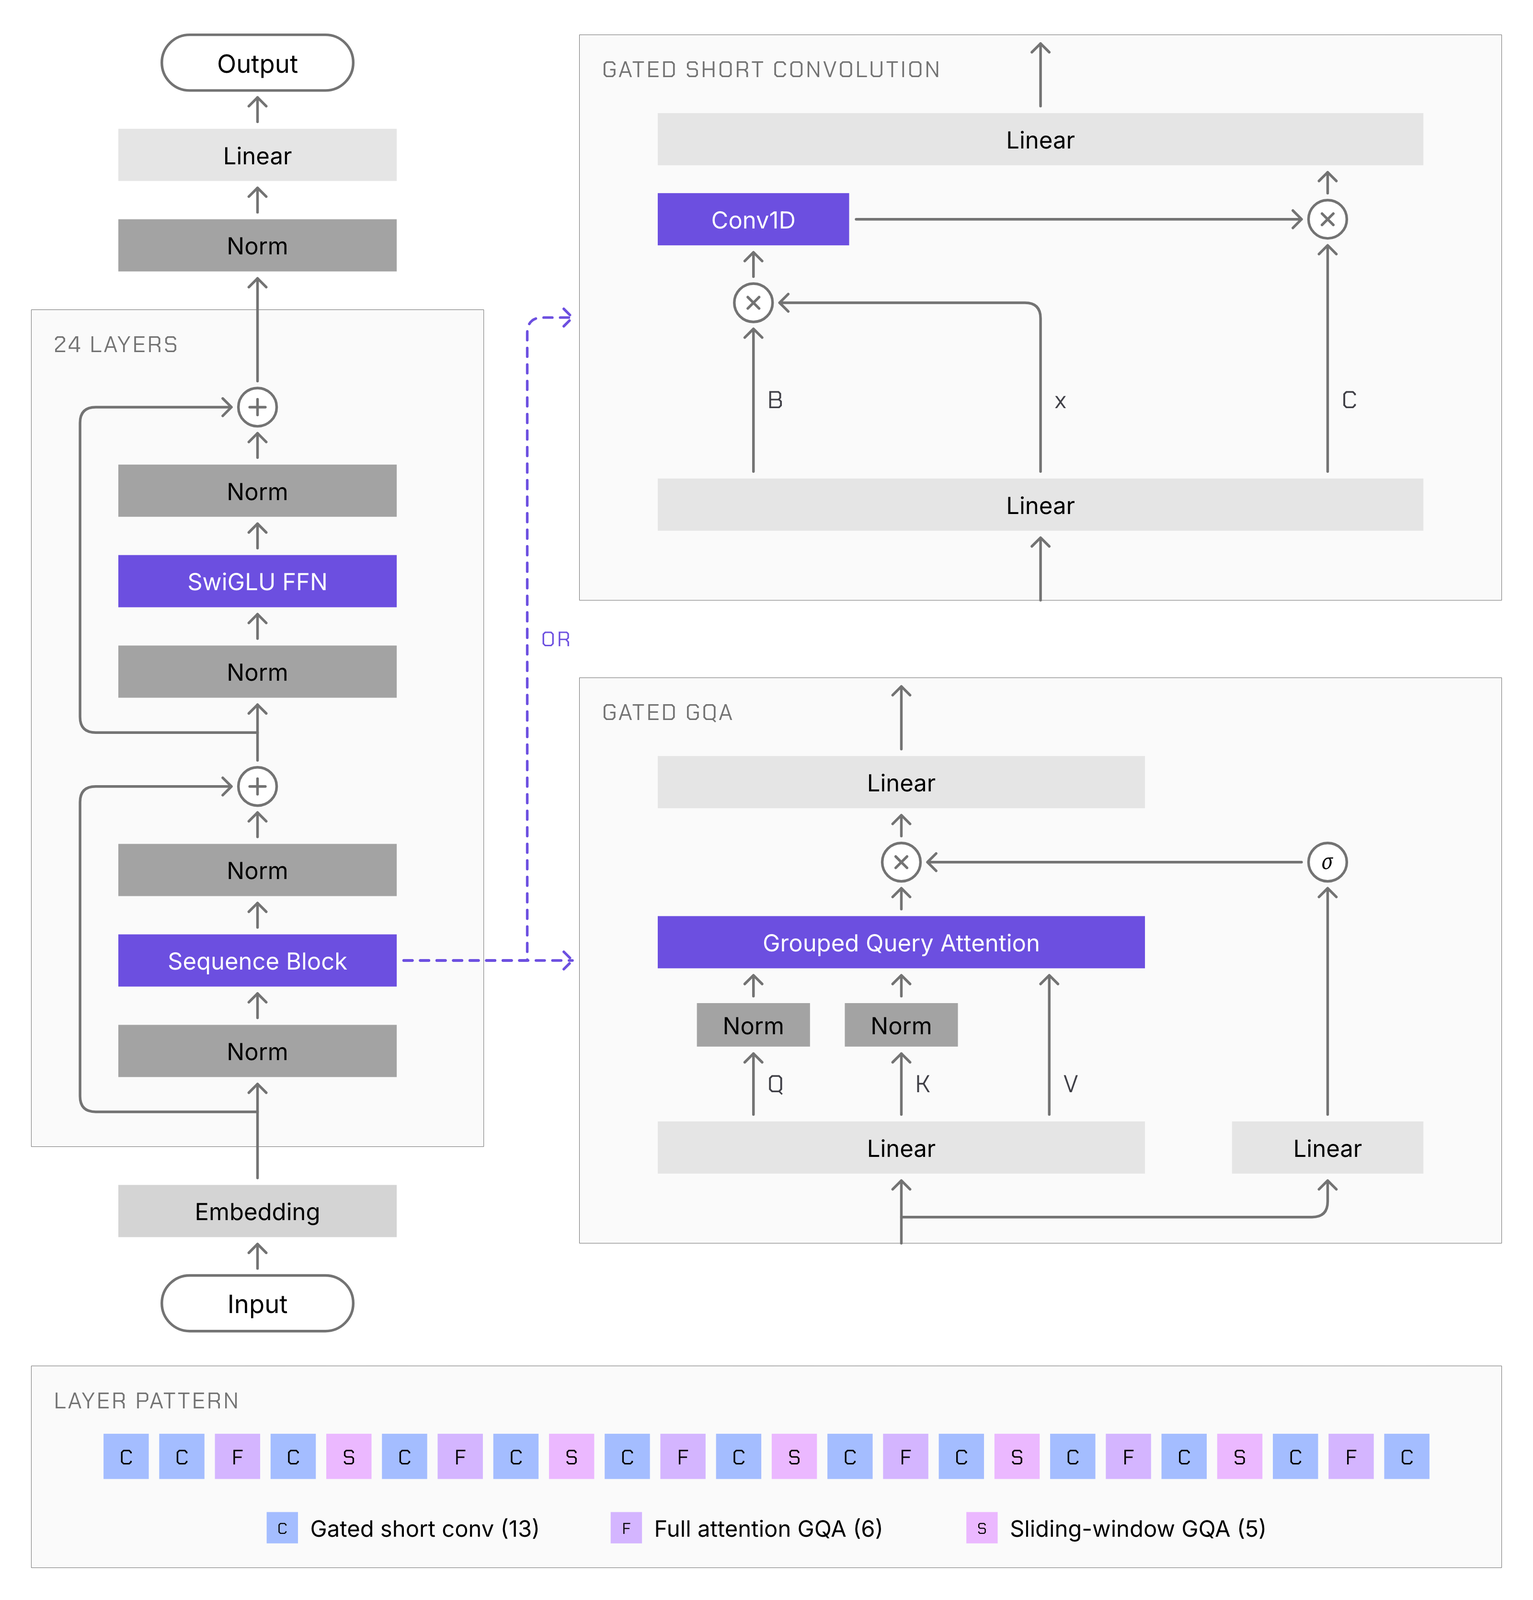
普通开发者不用记这些。
你只需要知道:大部分层干的是“看附近”,少数层干的是“看全局”。
这样做省算力。
官方还说,在 8K 上下文下,按参数归一以后,比 LFM2-1.2B 快约 25%。
注意,是“按参数归一”。
不是你直接拿来就快 25%。
预训练用了 22T token,最后 3.5T 的中训练加大了 agent 轨迹和工具调用的比例,上下文扩到 256K。
这句话翻译成人话是什么?
是 Liquid 在训练的最后阶段,专门喂了更多“怎么当 agent”的数据。
调工具,走流程,一步一步把事办完。
所以它不是一个顺便能当 agent 的聊天模型,而是一开始就照着 agent 的活去练的小模型。
至少,官方是这么设计的。
03
再看其他几个模型。
官方自报的成绩里,我挑几个对开发者有用的。
LFM3-1.7B 比 LFM2.5-2.6B 少 35% 参数,官方称更强。
VL-2B(实际 1.9B)在 62 项视觉基准上,均分从上一代 LFM2.5-VL-3B 的 57.6 到 71.4,官方称与 Gemma 4 12B 相当。
新的视觉编码器只有 164M,官方称精度和 Qwen3.5-2B 的视觉编码器相当,FLOPs 少 2.2 倍。
音频编码器是全因果的,首 token 低至 50 ms。
LiquidCodec 在 M4 Max 单线程上约 87 倍实时。
d1-2B 在 ImajevBench 上 75.5,对比 d1-3B 的 64.0。
这些数,全部是 Liquid 自己报的。
尤其是量化和端侧的数字,你换一台手机、换一个后端,结果可能完全不一样。
“与 Gemma 4 12B 相当”这种话,也是官方的说法。
相当到什么程度,要自己测。
04
那这东西对谁最有用?
我觉得是那种想做端侧 agent、又不想养一个大团队的开发者。
为什么?
因为官方给了 10 个 Colab 微调 notebook。
SFT、DPO、GRPO、CPT 都有。
例子也很接地气:
108 个工具的手机 app 调用。
收据转 JSON。
方程图转 LaTeX。
智能家居语音指令转函数调用。
说白了就是,官方把“怎么把它调成你自己的”这件事,提前做成了作业本。
LFM3-1.7B 还专门针对 Hermes Agent、Pi、OpenClaw 这些 harness 做了后训练。
机器人那边也有案例:VLA 在 LIBERO 四套件平均 96.2%,在 Jetson AGX Orin 上 50 ms 内能出一个动作块。
当然,这也是官方案例。
再单独说一下 d1。
这是我觉得最有意思的一个。
做一个假设。
假设一张客服工单进来,你想同时知道:它属于哪一类,急不急,要不要转人工。
普通做法,是问模型好几次,或者让它吐一大段文字,你再去解析。
d1 的思路是:一次前向,把这几个结构化问题一起答了,每个答案还附一个校准过的概率。
概率有什么用?
说白了就是,它会告诉你“我有多确定”。
确定的,自动处理。
不确定的,交给人。
官方博客里就有一个 support ticket 多问题单次前向的代码示例,想做的可以直接去看。
当然,“校准”好不好,也得拿你自己的工单测。
05
最后算一下开发者的账。
先说好处。
小,能塞进端侧。
拆得细,用哪个拿哪个。
能微调,作业本官方都备好了。
开放权重,不用每调一次付一次 API 费。
再说要花的。
第一,时间。
notebook 是起点,不是终点。你的场景、你的数据、你的评测,都得自己补。
第二,验证。
官方的数字大多是自报,端侧的速度更是“看设备说话”。
上线之前,在你目标用户的那款手机上跑一遍,比看再多报道都管用。
第三,预期。
1.7B 就是 1.7B。
它能在 WebArena-Verified 上从 3.02 走到 38.42,说明小模型做 agent 这条路走得通了一点。
但离“什么都能干”,还远。
所以下次再看到“12.7 倍”这样的标题,先别急着转发。
先问一句:谁算的,拿什么比的,原始数字是多少。
只能说,倍数是写给标题的,原始数字才是写给开发者的。
来源:Liquid AI 在 Hugging Face 的官方博客(2026-10-27);TechTimes 报道(2026-10-28)。38.42 与 3.02、62 项视觉基准均分、约 25% 提速(按参数归一、8K 上下文)、LIBERO 96.2% 等均为官方自报;“12.7 倍”为媒体口径;端侧速度与内存取决于设备和量化方式;开发者账为作者看法。