Nemotron 3.5 Transcribe:一个听提示词的转写模型
NVIDIA 发布 Nemotron 3.5 Transcribe:30B 总参、约 4B 激活,一个模型用提示词切换转写、说话人、翻译和问答,同时开放 Granary v2 数据;榜单与速度均为官方自报,NVFP4 版尚未发布。
一段录音的麻烦
假设你手上有一段会议录音,大约一个小时,好几个人轮流发言,中间夹着几个专业名词。
你想要的东西,其实不止一份文字稿。
1、每句话说了什么(转写)。
2、每句话是谁说的(说话人标注)。
3、每句话是什么时候说的(时间戳)。
4、最好还能翻成英文,或者直接问它"刚才谁反对了这个方案"(音频问答)。
传统做法是串起好几个模型:一个转写,一个做说话人分离,一个翻译,最后再拼起来。每多一道工序,就多一个出错的地方。
怎么解决呢?
10 月 28 日,NVIDIA 在 Hugging Face 官方博客发布了 Nemotron 3.5 Transcribe,同时放出数据集 Granary v2。它的思路是:把这几道工序合进一个模型,用自然语言告诉它要什么。
(说明一下,站内之前写过 Nemotron 3.5 Bolt,那是另一个模型,跟这篇讲的转写模型不是一回事。)
它能做什么
据官方博客,这是一个开放权重模型,可以在 Hugging Face 和 ModelScope 下载。
1、转写 40 种语言。
2、其中 31 种可以和英语互译。
3、13 种语言支持说话人标注。
4、单段录音最长约 1 小时,最多 8 个说话人。
5、支持词级时间戳。
还有一个细节:官方说各项任务支持的语种不完全一样,音频问答目前只用英语训练。
有一点要先说清楚:它面向的是录音,不是实时流式。也就是说,它适合处理"已经录好的文件",不适合拿来做直播字幕。
用提示词指挥是什么意思
普通的转写模型,你给它音频,它给你文字,没有商量的余地。
Nemotron 3.5 Transcribe 不一样,你可以在提示词里告诉它要什么输出:只要文字,还是要带说话人,还是要翻译。
官方博客举了一个医疗的例子。录音里可能出现 HbA1c、metformin 这类术语,你可以在提示词里把它们列出来,同时要求"仅在音频支持时使用"。
这句话很关键。
它的意思是:这些词是提示,不是答案。录音里真说了,才写进去,没说就不要硬塞。这有点像你请速记员帮忙,事先给他一张术语表,但叮嘱他别为了用上术语就乱改原话。
内部结构
模型的结构分两部分(英文原文是 speech encoder + LM)。
1、语音编码器,把声音变成特征。
2、一个 Mamba-Transformer 混合结构的 MoE 语言模型,负责理解和输出。
官方称总参数 30B,每次激活约 4B。
说话人信息是怎么来的呢?官方的做法是,用 Sortformer 提取说话人线索,和声学特征一起送进语言模型。所以,"谁在说话"不是事后拼上去的,而是模型生成文字的时候就知道的。
成绩怎么样
下面这些成绩都是 NVIDIA 在博客里公布的,包括几个第三方榜单的排名。
1、Hugging Face Open ASR 榜单,英文开源模型第一,平均 WER 5.33%(WER 是词错误率,越低越好)。多语种 7 个语种均值 4.62%,长音频 10.98%。
2、Artificial Analysis 的 AA-WER 为 2.8%,和一个 24B 激活参数的模型并列开源第一。AA-AgentTalk 为 1.8%。
3、说话人标注方面,David AI 的 21 语种测试,DER 为 18.26%,是参测的 14 个系统里最低的。VoiceArena 的 cpWER 为 32.4%,14 个系统里排第一。
榜单只能说明在这些测试集上的表现。你自己的录音换了口音、换了麦克风、换了领域,结果可能不一样。
速度这件事要看清楚
官方博客有一个很吸引人的说法:用即将发布的 NVFP4 量化版,在一张 RTX PRO 6000 Blackwell 上,3 分钟内可以处理 100 小时音频(条件是 30 秒的片段、高并发)。
请注意两点。
第一,这个量化版尚未发布。截至 10 月 29 日,NVIDIA 在 Hugging Face 上还只有原版和 DFlash2 两个检查点,官方博客仍写着量化版“即将推出”。
第二,条件是切成 30 秒片段、高并发处理,这是批量吞吐,不是你手上那段一小时录音的等待时间。
推理方面,vLLM 和 SGLang-Omni 首日支持。不想自己部署的话,Baseten、DeepInfra、Simplismart 提供托管。
Granary v2:自己调的数据
这次发布的另一半是数据----Granary v2。
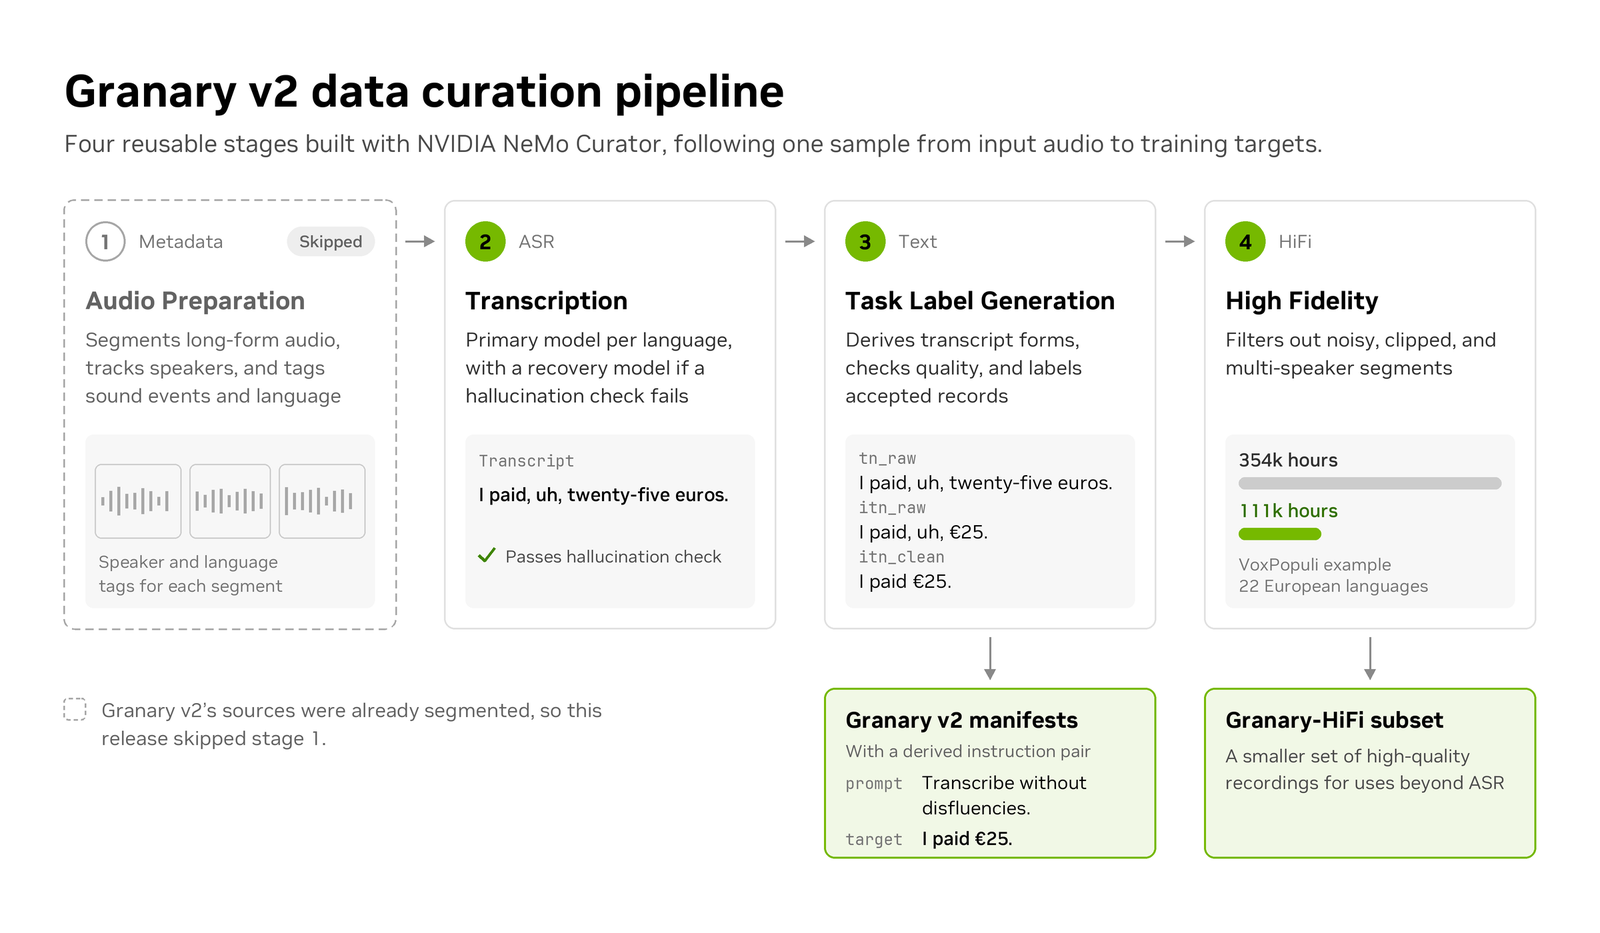
据官方博客,Granary v2 的公开清单有 463,062 小时音频,覆盖 48 个语种,来自 16 个来源语料。上一版 v1 是 25 个语种。
每条录音给出三种转写形式:
1、tn_raw:保留口语原样,比如 "twenty-five euros"。
2、itn_raw:把读法还原成书面写法,比如 "€25",但保留语气词。
3、itn_clean:再把语气词这类东西清掉。
为什么要三种?因为不同用途要的文字不一样,字幕要贴近原话,会议纪要要干净。
数据管线分四个阶段:音频准备、ASR 转写(带回退模型)、任务标签生成、HiFi 过滤。过滤有多狠呢?官方举例,VoxPopuli 从 354k 小时过滤到 111k 小时。整个管线用 NeMo Curator 加 Ray/Dynamo 搭建。
一个医疗微调的例子
官方博客给了一个案例:Eka Care 的印度医生录音基准。
1、什么都不训练,只在提示词里写明"英语 + 拉丁字母",全集 WER 从 30.8% 降到 23.8%。
2、微调之后,降到 11.8%。
3、在更干净的留出说话人集上,从 22.44% 降到 12.17%,官方称相对降低 45.8%。
4、整个适配约 14 GPU 小时,用的是一张 GB300。
5、代价是通用能力略有下降:LibriSpeech test-clean 从 1.54% 微升到 1.69%。
第 5 点很值得注意。领域调得越专,通用场景就可能越差一点,这是取舍,要自己评估。
官方还附了一个 agent skill,可以让 coding agent 跑完整个微调流程。
怎么上手
如果只是想试试效果,最省事的是用托管服务,前面提到的 Baseten、DeepInfra、Simplismart 都可以。
如果要自己部署,可以走 vLLM 或 SGLang-Omni。
如果要调自己的领域词,顺序大概是:先只改提示词,看看能好多少;不够,再用 Granary v2 的管线准备数据去微调。医疗案例里,"只改提示词"这一步就已经有明显改善,这说明提示词这一步不该跳过。
局限
总结一下用之前要想清楚的事。
1、它面向录音,不是实时流式。
2、宣传的高吞吐依赖尚未发布的 NVFP4 版本。
3、所有成绩来自官方博客,包括它引用的第三方榜单排名。换成你的数据,要自己测。
4、医疗案例是官方选的例子,换一个领域、换一批录音,效果不一定一样。
一句话总结:Nemotron 3.5 Transcribe 把转写、说话人、翻译、问答塞进一个模型,用提示词切换,再给你一套数据管线去调自己的领域词。
(完)
来源:NVIDIA 在 Hugging Face 的官方博客。WER、AA-WER 并列第一等榜单成绩与吞吐数字均为官方自报(包括博客引用的第三方榜单排名),AA-WER 并列的另一模型官方未点名;高吞吐依赖 NVFP4 量化版,截至 2026-10-29 Hugging Face 上只有原版与 DFlash2 检查点;Eka Care 案例为官方选取的客户案例。