削足适履之外
Infini-AI-Lab 开源 Hermit:模型和 harness 都不动,给 agent 训一个“harness 适配器”;OfficeQA、CL-Bench、ServeLearnBench 的数字均为项目方自报的单次结果。
中国人讲「削足适履」,是当笑话讲的:鞋小了,不去换鞋,倒把脚削掉一块。可这两年用 AI 工具的人,多少都干过类似的事。模型不合手,就去改自己的工作习惯;工具不合手,就去迁就工具的脾气。改来改去,脚削了不少,鞋还是那双鞋。
另一条路是换鞋。这条路的口号大家都听熟了:等下一个更大的模型,等下一个更聪明的 agent。问题在于,新鞋穿上也未必合脚,而且每换一次,前面磨出来的那点默契全部归零。手艺人都知道,工具用顺手要时间,换得太勤,手永远是生的。
所以当我看到 Infini-AI-Lab 开源的 Hermit,第一反应是:哦,有人想走第三条路了。脚不削,鞋也不换,往鞋里垫一副鞋垫,而且这副鞋垫还会自己照着你的脚型慢慢长。
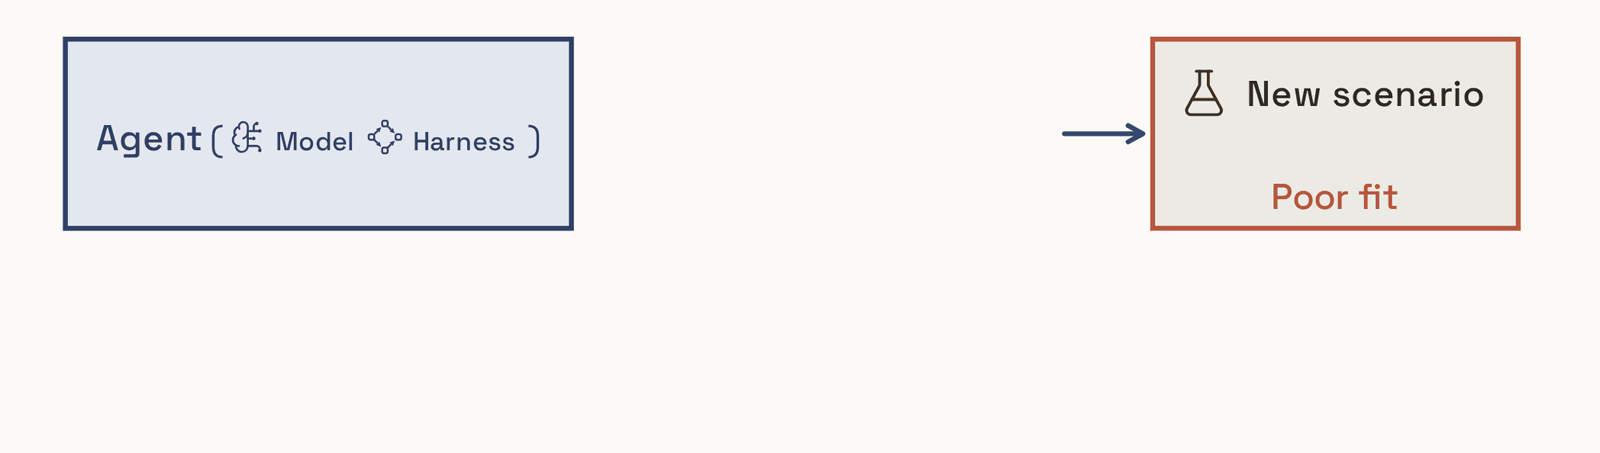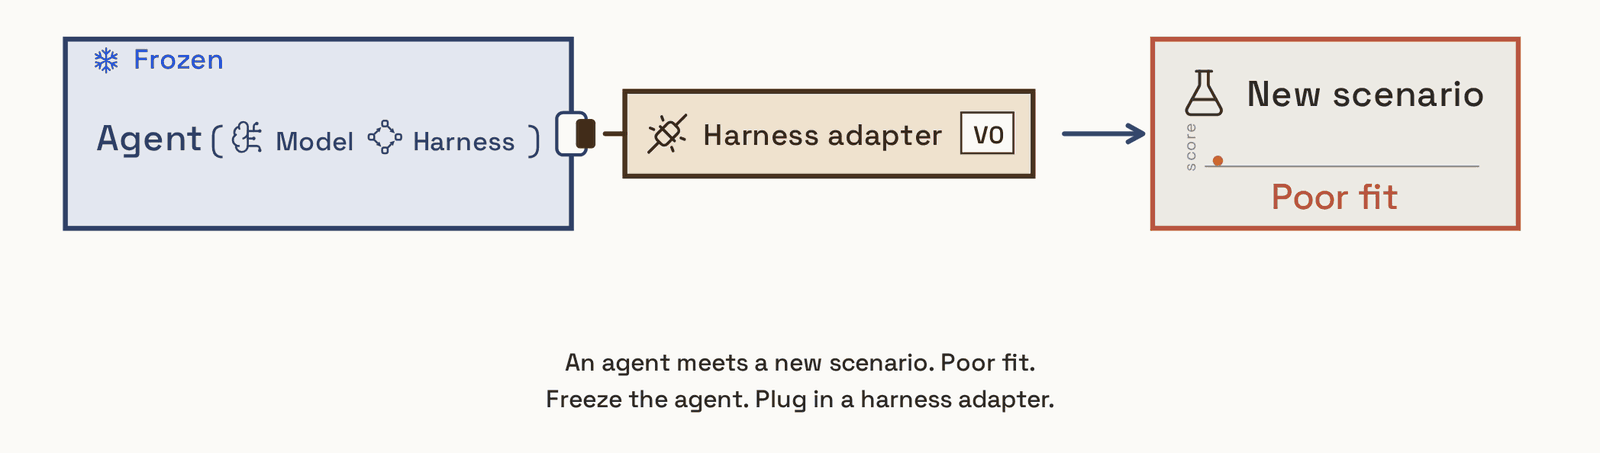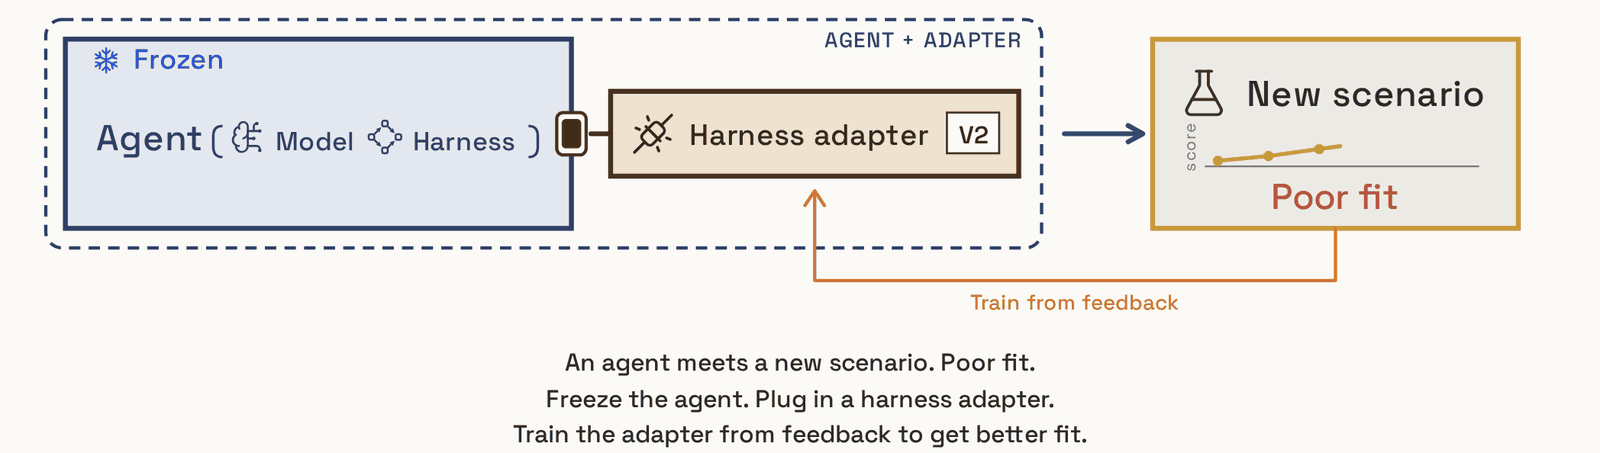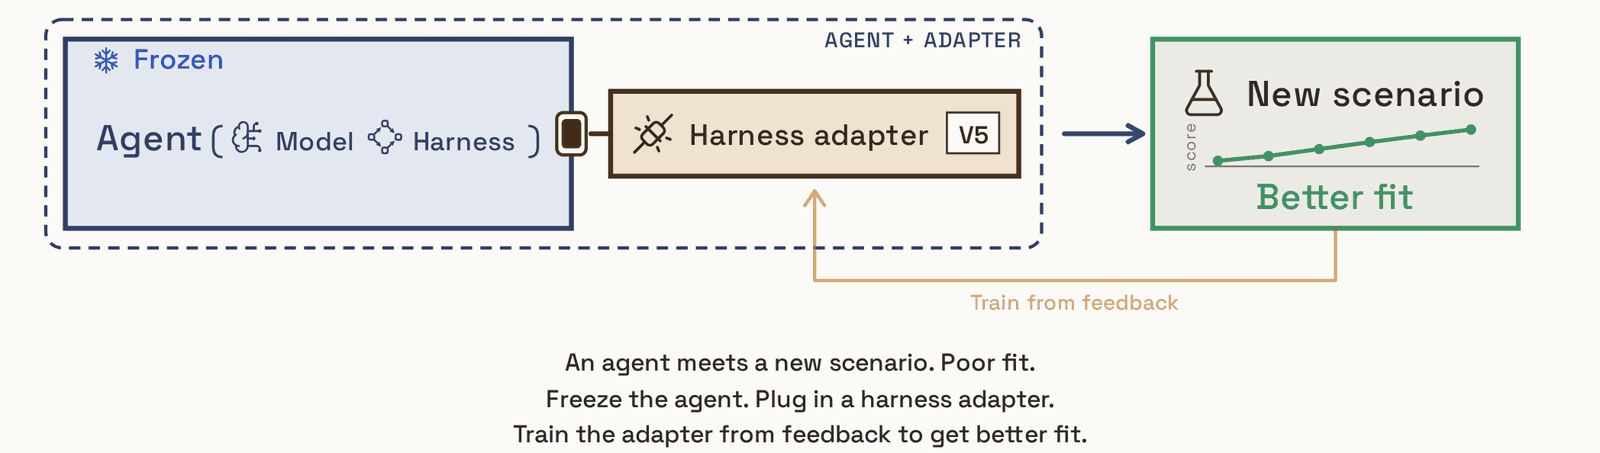
据 GitHub 仓库和项目主页的说法,Hermit 是一个训练、评估、部署「harness 适配器」的框架,Apache-2.0 协议,v0.1.0 于北京时间 10 月 26 日发布,CMU 博士后 Haizhong Zheng 在 10-27 于 X 上宣布。它的类比说得很直白:LoRA 是给模型加适配器,Hermit 是给 agent 加适配器,原来的模型不动,原来的 harness 也不动。
适配器里装什么?指令、skills、记忆、工具、可执行代码,还有多个 agent 之间怎么协作的逻辑。说穿了,就是平时大家手写在各种配置文件里的那些东西,只不过现在把它们当成一个可以训练的外部件。Codex、Claude Code 这类工具本身是黑盒也不要紧,适配器挂在外面,通过它们支持的扩展接口进去。
训练的办法,有点像老师傅带徒弟。Trainer 先让 agent 去跑任务,judge 给结果打分,Evolver 读完这一轮的运行轨迹,提出一个新版本的适配器,校验通过再提交。每个版本都存在一棵 git 树里,改坏了可以回滚。learner 程序还能放进 bubblewrap 沙箱里跑,不过这一条只限 Linux。
这里头我最看重的,反倒是那棵 git 树。调教 agent 的人大概都有过这种经历:某天改了一句规则,效果忽然变差,却怎么也想不起来上一个好用的版本长什么样。能回滚,意味着试错的代价变小了;试错的代价小了,人才敢放手让机器去改。说到底,敢不敢让它自己长,取决于长歪了能不能拉回来。
方法也不止一种。框架里内置了五种进化法:GEPA、SkillOpt、MetaWorld Model(MWM)、Harness²、Continual Harness,ACE 和 ReHarness 标着「待出」。Harness² 这个名字,站内读者也许在 google-harness2 那篇里见过。Hermit 文档标注的出处是 Xu et al., 2026(arXiv 2610.14224),代码指向 google-research/harness2,和那篇写的是同一个方法,Hermit 内置的是对它的接入。
上手的门槛压得很低。pip install hermit-harness 就能装,或者 clone 下来 pip install -e .,要求 Python 3.12+。离线的 Quick Start 不需要 GPU,不需要账号,也不需要数据集,属于「先让你摸一摸」的那种设计。
后端支持 Fireworks、OpenAI、Anthropic、DeepSeek、vLLM、SGLang、Ollama,自家机房里跑模型的人也照顾到了。对只想先看看热闹的宅男来说,这一点很友好,不用先办卡、先充值、先下载一堆文件,才发现自己根本不需要它。
命令行就五个动作:check、train、eval、deploy、convert。hermit deploy --host codex 把训练好的适配器写进工作区,hermit convert --target claude-code 则能把它导出成 Codex、Claude Code、Pi、Hermes 的原生插件。
示例里有一个适配器,专门协调 5 个 Codex 合作证明一个 Lean 定理,这大概是整个项目里最像「炫技」的一段。不过炫技归炫技,它至少说明了一件事:适配器里装的不只是几句话,也可以是一整套让几个 agent 分工、共享状态、一起干活的规矩。
说到这里,听起来几乎是完美的故事:脚不受罪,鞋不用换,鞋垫还能自己长。可老狗看东西,习惯先翻到最后一页看成绩单。年纪大了,被漂亮的开头骗过太多回,知道故事讲得越顺,越要看看账本。而这份成绩单,恰恰是最需要冷静读的部分。
先说口径。据项目方自报,这些结果都用 GLM 5.3 Flash 跑,而且多为单次运行。单次运行是什么意思,做过实验的人都懂:运气好的一次和运气差的一次,可能差出不少,一次的数字只能算「看到了苗头」,算不上「证明了规律」。
再看具体的数。OfficeQA 上,不加适配器是 0.541,加上 Harness² 之后是 0.651。CL-Bench 的数据库探索任务里,MWM 得到 0.795,上下文基线是 0.580。这两组看起来都挺体面,适配器确实把分数往上推了。
但同一张表里还有一行,我觉得比前面所有好看的数字都重要:纯 prompt 的适配器只有 0.470,低于 0.580 的基线。也就是说,如果你以为「适配器」就是往里塞一段更长更花哨的提示词,那结果可能比什么都不加还差。鞋垫垫错了,比不垫更硌脚。
这一行数字,项目方没有藏,老实写在那里。我反倒因此多信了它几分。现在发布开源项目,大家都习惯只把最亮的那几个数字放在首页,肯把「这个办法不行」也一并摆出来的,不算多。
还有一组更值得琢磨。ServeLearnBench 上,MWM 得到 45.3,而 oracle 是 89.2。这个 oracle 是基准榜单上把隐藏策略直接交给模型时的分数,你可以理解成「答案的规则已经告诉你了」能拿到的分。两个数摆在一起,意思很清楚:适配器有用,但离天花板还远,路才走了一段。
所以怎么看 Hermit?我的看法是,它真正有意思的地方不在分数,而在思路的转向。过去这段时间,大家给 agent 调教的那些东西,规则、技能、记忆,都是手工活,写完就写完了,好不好全凭感觉。Hermit 想把这些手工活变成可以训练、可以评估、可以回滚的工程。这个方向是对的,至于这个版本能走多远,单次运行的成绩单说了不算。
对想动手的人,我的建议也很朴素:先用离线 Quick Start 摸清楚它的套路,再拿自己的任务和自己的评分标准去试,别直接拿首页的数字当承诺。尤其要盯住那个 0.470,它提醒你,适配器不是越长越好,乱训一通,鞋垫也会长歪。
佛经里讲「应无所住而生其心」,后人常把它讲得很玄。放在这件事上,我宁愿把它读得俗一点:不要死守着某一个模型,也不要死守着某一套写好的规则,让外面那一层跟着你的活一起长。脚还是自己的脚,鞋还是那双鞋,变的只是中间那一层……这本来就是手艺人一直在干的事,不是么?
来源:GitHub 仓库;项目主页;MarkTechPost 报道(2026-10-29)。OfficeQA、CL-Bench、ServeLearnBench 分数均为项目方自报,单次运行;ServeLearnBench 的 oracle 为基准榜单上直接给出隐藏策略时的分数;Harness² 出处据 Hermit 文档(Xu et al., 2026,arXiv 2610.14224);“削足适履”的比喻为作者看法。