先把老师教对(微软 Mage-VL-Cowork 和「该点鼠标还是该写代码」这个判断)
微软 Mage 团队开源 4B 电脑操作 agent Mage-VL-Cowork:OSWorld-Verified 66.0% 为官方自报,关键不在模型大小,而在教师 harness 给了哪些通道。
同一个表格任务。
一边是 6 步,39 秒。
另一边是 39 步,9 分 56 秒。
任务本身很普通:在 LibreOffice Calc 里合并单元格,再加一张图表。
据微软 Mage 团队的项目页,快的那一边是 Mage-VL-Cowork,一个 4B 参数的电脑操作 agent。它打开终端,写了一段 Python。这组步数和用时是官方自报的演示对照。
慢的那一边是 Qwen3.6-27B,全程只用图形界面,一下一下地点。
差距不在模型大小。
在于它有没有意识到,这件事根本不需要点。
两只手(以及为什么大多数 agent 只有一只)
电脑操作 agent 的默认画像是这样的:看一张截图,决定鼠标移到哪里,点一下,再看一张截图。
像一个实习生,只是没有快捷键,也不会写脚本。
另一条路是纯代码 agent。
它活在终端里,几行命令就能改完一堆文件,却看不见按钮在哪里,碰到只能在界面里完成的事就卡住。
两条路各自都走得通。
问题出在中间。
真实的电脑工作,很少只属于其中一边: - 改表格内容,写代码更快也更准 - 确认图表渲染出来长什么样,得看屏幕 - 在没有命令行接口的应用里改一个设置,只能用鼠标 - 跨好几个应用的流程,两只手要换着用
Mage-VL-Cowork 想做的,是一个能自己换手的 agent。
据官方介绍,同一个 4B 策略在每一步自己选通道:要么截图加鼠标键盘,要么终端和代码。
没有外部调度器替它分配。
判断长在策略里面。
这听起来像一个工程细节。
其实是一个关于判断力的问题。
成绩单(先看是谁报的)
讲它怎么训练出来之前,先把数字摆清楚。
以下都是微软 Mage 团队在项目页和 Hugging Face 上的官方自报,模型以 Apache-2.0 许可发布,10 月底上线。
- OSWorld-Verified 66.0%,50 步预算,两次运行取平均,共 361 题
- 分类成绩:OS 类 87.5%,多应用工作流 62.7%
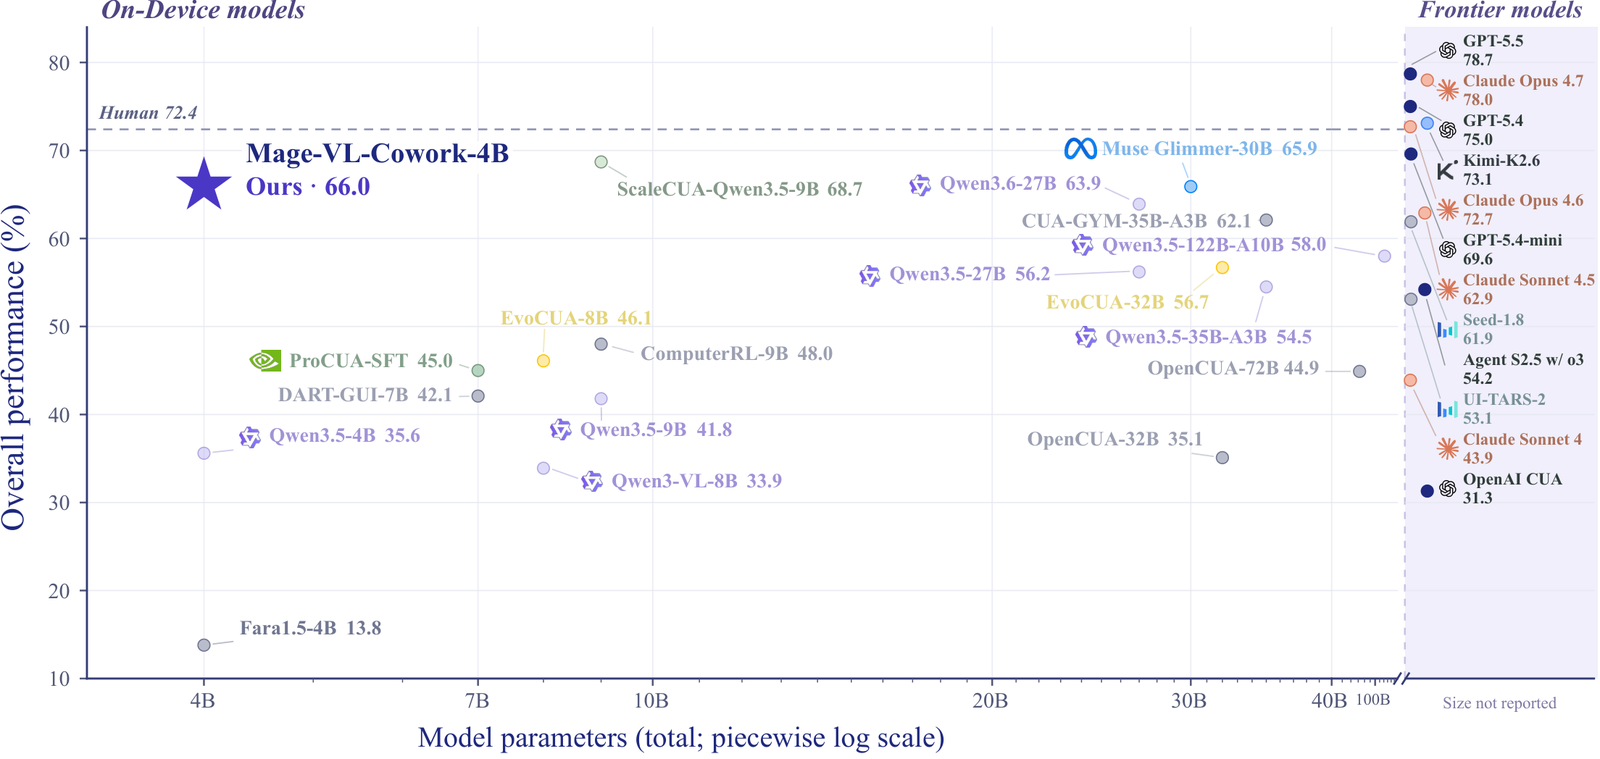
- 对比表里,Muse Glimmer-30B 是 65.9%,Qwen3.6-27B 是 63.9%
- 也有比它高的:SCALECUA-Qwen3.5-9B 是 68.7%,GPT-5.4-mini 是 69.6%
- 表里的前沿闭源模型更高:GPT-5.5 是 78.7%,Claude Opus 4.7 是 78.0%,GPT-5.4 是 75.0%,Kimi-K2.6 是 73.1%
- 人类是 72.4%
这张表值得注意的地方,是官方自己把更高的那几行也放了进来。
它不是全场第一。
一个 9B 的专门模型比它高,一个 mini 版前沿模型也比它高,更大的前沿模型就更不用说了。
它想说明的是另一件事:4B 能挤进这个区间,靠的不是参数。
真正的杠杆在上游
做小模型 agent,最常见的思路很直接。
找一个强的教师模型,让它干活,把轨迹录下来,喂给学生。
教师越强,学生越好。
工具给得越全,教师越强。
逻辑通顺。
只是官方的对照实验说,最后一环不一定成立。
工具多了,学生反而学坏了。
据项目页的对照,在 672 道留出的多应用任务上:同样用 GPT-5.4 当教师,一套 harness 只给 GUI 加编码两种通道,教师成功率 92.0%。另一套再加上无障碍树(AX)通道,教师成功率 89.6%。
在教师这一侧,两者相差不大。
但用各自的轨迹蒸馏出来的 4B 学生,一个是 37.6%,一个是 25.1%,官方给出的差距是 12.5pp。
教师只差一点,学生差了一大截。
下面是我的理解,属于推断,不是官方结论。
多一个通道,教师就多一种做事的路线。强模型能在几条路线之间随机应变,每条轨迹看起来照样成功。
可对小模型来说,这些轨迹里充满了「同一件事这次这么做、下次那么做」的噪声。
它学到的不是判断,而是犹豫。
这就是 Mage 团队和常规做法分开的地方:先改造教师的 harness,再蒸馏。
不是先找最强的老师。
是先让老师用一种值得被模仿的方式干活。
站内之前写过只给 agent 一个工具的 Nodecode,那一篇讲 harness 怎么设计,这一篇讲 harness 怎么决定下一代模型学到什么。
它是怎么一步步长出来的
据官方介绍,训练从 Mage-VL 的一个中间检查点出发,一共五个阶段。
1) GUI 中训
先让模型看懂屏幕。
2) GUI agent SFT
学会用截图、鼠标、键盘完成任务。
3) 编码与终端 SFT
学会另一只手。
4) 混合 SFT
把两只手放进同一个策略,学会在每一步做选择。
5) 在线混合 RL(GRPO)
在真实环境里自己试,自己改。
顺序本身就是一个观点:先把两种能力各自练扎实,再学怎么组合。
官方给出的阶段成绩是:GUI SFT 45.56%,混合 SFT 55.84%,RL 之后 66.0%。
RL 这一步还有一个容易被忽略的变化。
据官方数据,平均模型调用次数从 21.57 降到 18.77,输出 token 从 7,374 降到 5,499。
分数上去了,话变少了,步子也变少了。
这和开头那个表格任务是同一个信号。
更好的 agent 不是做得更多,而是更早知道该用哪只手。
数据从哪里来
训练一个会换手的 agent,需要大量既有界面操作、又有代码操作的任务。
现成的不够,只能合成。
官方的合成管线叫 Mage-CUA-Forge,自报数字如下: - 293,806 个任务 - 6,915 个技能 - 318,837 条混合轨迹 - 单任务生成成本从 $0.906 降到 $0.158,官方标注为 -82.6%
这里的重点不在规模。
在成本曲线。
合成任务越便宜,「先改造老师、再大量录轨迹」这条路就越走得通。
如果每个任务都很贵,你只能用默认 harness 一次录完了事,没有余地反复打磨上游。
如果你也在做 agent
这篇不是劝你去下载一个 4B 模型。
它更像一面镜子。
下面几条是我从中读出来的原则,不是官方建议。
1) 先审视 harness,再审视模型
效果不好时,第一反应往往是换更大的模型。Mage 的对照说明,同一个教师,换一套工具组合,结果就不一样。
2) 每加一个工具,都问它会不会制造歧义
工具清单越长,看起来越安心。但如果两个工具能做同一件事,模型每一步都要多做一次没必要的选择。对强模型是小成本,对小模型可能是大问题。
3) 把「选哪条路」当成能力,而不是配置
很多系统把「这一步用界面还是用脚本」写成外部规则。Mage 的思路是让策略自己学。规则写得再细,也追不上任务的变化。
4) 看效率,不只看成功率
调用次数、输出 token、完成时间,这些数字告诉你 agent 是在思考,还是在乱试。
判断力可以被教会,也可以被教坏
Mage-VL-Cowork 最有意思的地方,不是 66.0% 这个分数。
是它提醒你:一个系统能学到什么,取决于它看到的示范长什么样。
示范里充满犹豫,它就学会犹豫。
示范里每一步都干净利落,它才有机会学会判断。
这一点放在模型身上成立,放在人身上大概也成立。
你给别人的示范,决定了他们会变成什么样。
先把老师教对。
来源:Mage-VL-Cowork 项目页;Hugging Face 模型卡。OSWorld-Verified 成绩、6 步 39 秒的演示对照、教师与学生成功率、Forge 合成数据与成本均为微软 Mage 团队官方自报,未经第三方复现;“先改造教师 harness 再蒸馏”的归纳为作者看法。