MiniCPM-OCR 1.0:一个会说"我不确定"的 OCR 组合
OpenBMB 开源 MiniCPM-OCR 1.0 与判定模型 Jev:一个负责识别,一个负责判断识别结果能不能信;榜单、速度与 JevOCRBench 分数均为官方自报。
一、OCR 的老毛病
OCR 软件有一个老毛病:它不会说"我不确定"。
一页扫描件丢进去,出来的永远是一段完整、通顺、看起来没问题的文字。
至于其中哪个数字认错了、哪个表格串了行,它不会告诉你。
这就是 OCR 落地最麻烦的地方。难的不是认字,而是不知道哪里认错了。
结果就是,凡是要紧的文档,比如合同、票据、报表,识别完了还得有人从头到尾再看一遍。机器省下来的时间,又被人工核对吃掉了。
10 月 27 日,OpenBMB 发布了 MiniCPM-OCR 1.0,同时发布了一个配套模型 Jev。
我觉得,后者比前者更值得说一说。因为它专门回答一个问题:"这段认得对不对?"
站内之前写过 baidu-unlimited-ocr-2,那篇关心的是一次能吃下多少页,这一篇关心的是认出来的东西能不能信。
二、MiniCPM-OCR 1.0 是什么
先说识别模型本身。
据 HF 模型卡和 OpenBMB 文档,MiniCPM-OCR 1.0 的参数量是 1.3B,基于 MiniCPM-V 4.6(SigLIP + Qwen3.5)训练,以中文和英文为主。
它能处理的内容包括:
1、文字
2、表格
3、公式
4、图表
5、印章
6、关键信息抽取,输出 JSON
整页解析分成三步:先用 PP-DocLayoutV3 做版面检测,把页面切成一个个区域;再由模型逐个区域识别;最后由 minicpmvocr SDK 按阅读顺序拼成 Markdown。
其中,表格输出为 HTML,公式输出为 LaTeX。这对后续处理很友好,可以直接喂给别的程序。
三、官方自报的成绩
下面的数字,都是 OpenBMB 官方自报的。
1、Real5-OmniDocBench 得分 93.68,OCRBench v2 得分 54.7。
2、速度方面,在 RTX 5090 上约 1.2 页/秒。测试条件是 OmniDocBench v1.6 的 1651 张图、并发 1、加速配置。
3、官方称,这个速度约为 PaddleOCR-VL-1.6 的 1.49 倍、MinerU2.5 Pro 的 3.62 倍。
4、使用 DSpark 投机解码,端到端效率 +55%。
需要注意,速度和测试条件是绑在一起的。换一块显卡、换一种并发方式,结果都可能不一样,最好用自己的文档实测。
四、Jev:专门打分的模型
现在说重点。
MiniCPM-OCR Jev 是一个 2B 模型,由 Qwen3.5-2B 加一个二分类头组成。
它的输入是一个图片区域,加上一段候选的识别结果;输出是一个 0–1 之间的置信概率。
也就是说,Jev 自己不认字,它只负责判断"这段识别结果对不对"。
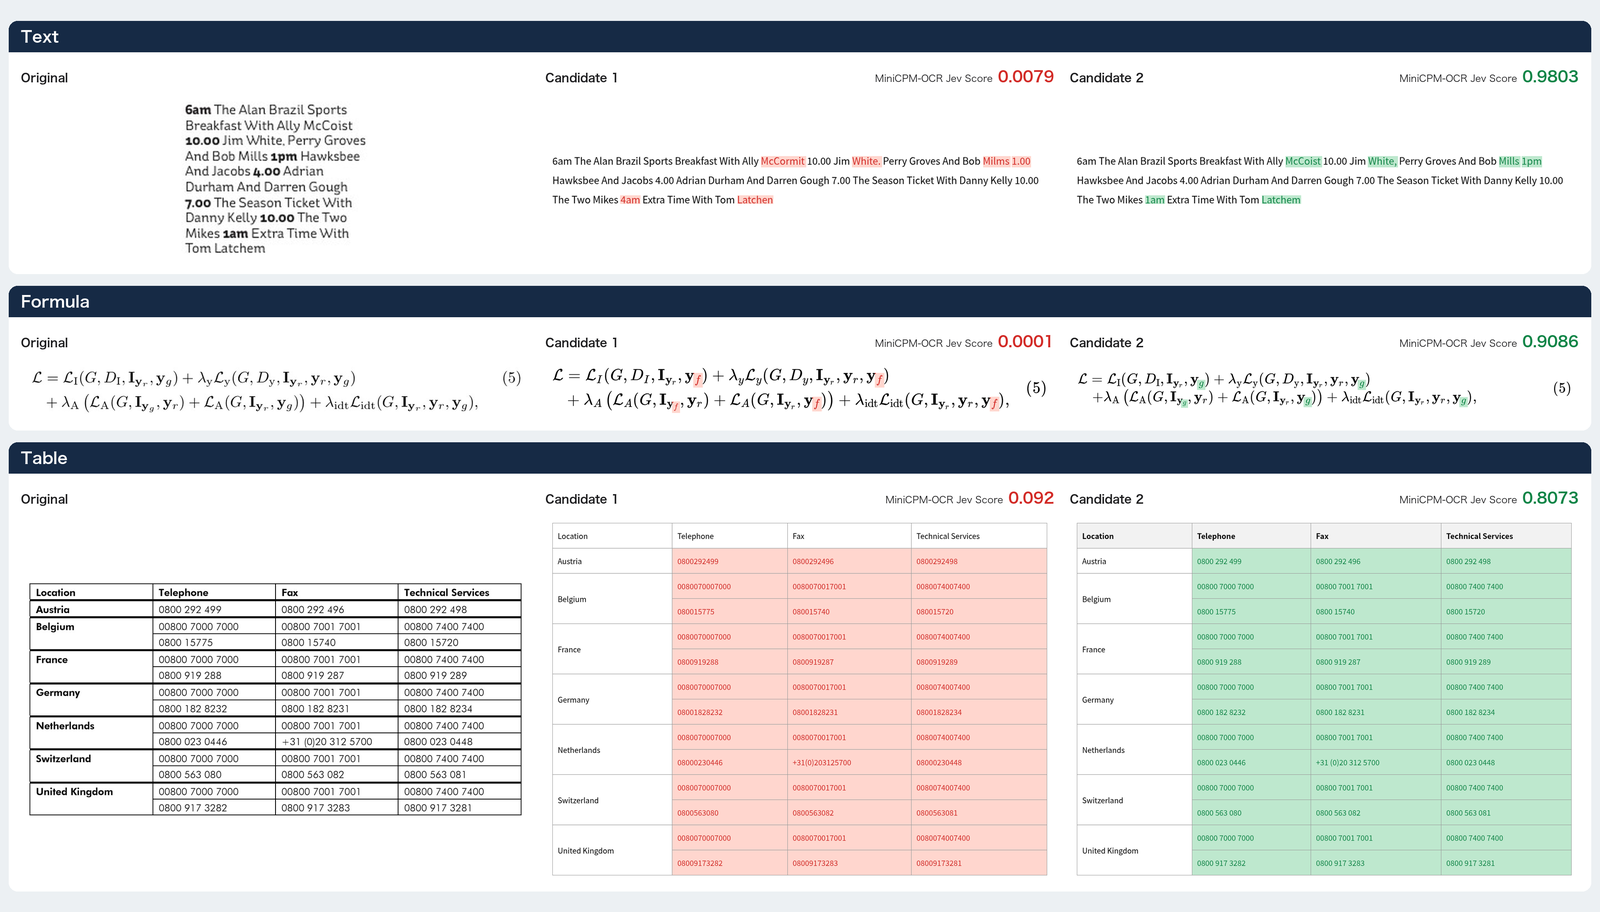
这个设计有一个直接的好处:它可以配合其他 OCR 引擎使用,不一定非得搭配 MiniCPM-OCR。
据官方自报,Jev 在自建基准 JevOCRBench 上的判定 AUROC(×100)是 93.6,这是模型卡的写法,OpenBMB 文档页写的总分是 93.5,两处差 0.1,这里以模型卡为准。注意,这是自建基准,不是第三方榜单。
五、怎么用 Jev
按照 Jev 模型卡的说明,大致有两种用法。
第一种是"阈值分流"。
用你自己的样本挑一个阈值。分数高于阈值的结果自动放行,低于阈值的送去人工复核。
这样一来,人工只需要看那些机器拿不准的部分,而不是从头看到尾。阈值怎么定,取决于你的文档类型和对错误的容忍度,官方没有给统一答案。
第二种是"多选一"(Best-of-N)。
让几个 OCR 模型分别识别同一个区域,再用 Jev 给每个候选打分,选分数最高的那个。
模型卡还提醒了一个细节:使用分数之前,先检查返回结果里的 verdict 字段是否为 scored。如果不是,这个分数就不该当真。
六、一条完整的流水线
把两个模型放在一起,就是一条"解析 + 质检"的流水线。下面是我按官方说明整理的大致流程。
1、版面检测:PP-DocLayoutV3 把整页切成一个个区域,并确定它们的位置。
2、逐区域识别:MiniCPM-OCR 1.0 认出每个区域的内容。
3、逐区域打分:Jev 拿着原图区域和识别结果,给出一个置信概率。
4、分流:高分区域直接进入下游,低分区域标记出来,交给人工复核。如果你愿意多花一点算力,也可以换一个 OCR 引擎重试,再让 Jev 打一次分。
5、拼装:SDK 按阅读顺序拼成 Markdown,表格是 HTML,公式是 LaTeX。
这里的关键是第 3 步和第 4 步。质检是按区域做的,不是按整页做的。
这意味着,一页里只有一个表格拿不准的话,人工只需要看那一个表格,其余部分照常流转。
第 4 步里的"换一个引擎重试",就是前面说的 Best-of-N 思路的变体。因为 Jev 不挑识别模型,所以你手上已有的 OCR 引擎,也可以接进来当候选。
七、部署
两个模型都采用 Apache-2.0 许可证,可以商用。
推理框架方面,vLLM、SGLang、llama.cpp、Ollama 首日支持,还提供 GGUF、AWQ、GPTQ 量化版本。
官方配方的验证环境如下:
1、RTX 5090 32GB 显卡
2、Python 3.12
3、驱动 ≥580(CUDA 13)
4、预留 40GB 磁盘
另外,官方建议 SDK 与识别后端分开环境安装,免得依赖互相打架。
八、我的看法
这个组合的意义,不在于又多了一个 OCR 模型。
OCR 模型已经很多了,分数一个比一个高。但是,分数再高,也不会是满分,总有认错的时候。
真正的问题一直是:错在哪里?
过去的做法,通常是把识别模型做得更大、更准,指望错误率低到可以忽略。但是,对合同、票据这类文档来说,错一个数字就可能出问题,"错得少"并不等于"可以不查"。
Jev 的思路是,与其追求永远不出错,不如承认会出错,然后把"可能出错"的地方标出来。
这有点像工厂里的质检工位。生产线负责做,质检负责挑,两件事分开,各自都能做得更专。
当然,Jev 本身也会判断失误,它的分数同样是一个概率,不是保证。阈值定得太松,错的会漏过去;定得太紧,人工复核的量又会上来。
如果你需要批量处理中英文档,又不想每一页都人工核对一遍,可以试试这个组合。
(完)
来源:MiniCPM-OCR 1.0 模型卡;MiniCPM-OCR Jev 模型卡;OpenBMB 文档;Neural Brew 报道。Real5-OmniDocBench 93.68、OCRBench v2 54.7、RTX 5090 约 1.2 页/秒等均为官方自报;Jev 的 JevOCRBench 为自建基准,模型卡写判定 AUROC(×100)93.6,文档页写 93.5,正文取模型卡;阈值怎么定、要不要上 Jev 为作者看法。